Zum Inhalt springen
AMD Instinct MI400 Serie · CDNA 5 · HBM4

AMD Instinct MI400 Serie kaufen - MI455X, MI440X & MI430X Server für KI und HPC

Die neue Instinct-Generation mit bis zu 432 GB HBM4 pro GPU - für KI-Training, LLM-Inferenz, wissenschaftliches HPC und Sovereign AI. Nelpx übernimmt Konfiguration und Lieferung - vom 8-GPU-Server bis zum Helios-Rack.

IT-Systemhaus für HPC & AI-Infrastruktur · DACH-Region · Lieferung EU-weit

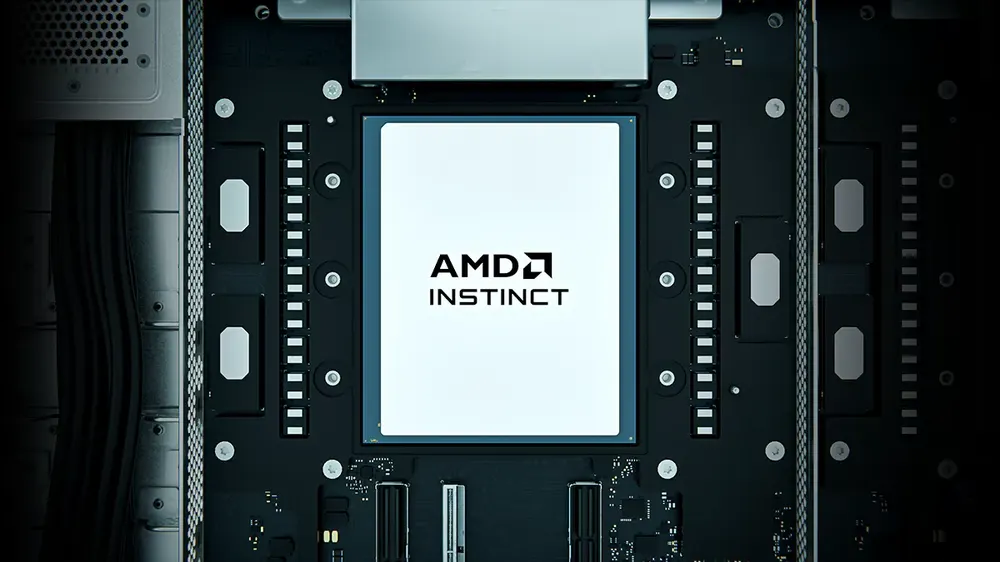
AMD Instinct MI455X GPU mit CDNA 5 Architektur und 432 GB HBM4 auf dem Mainboard
AMD Instinct MI455XCDNA 5 · 2-nm-Compute-Dies · 320 Mrd. Transistoren
PreisProjektbezogen über GIGABYTE-Plattformen Preis auf Anfrage
Vorbestellung nach Allokation
432 GBHBM4 pro MI455X
23,3 TB/sSpeicherbandbreite pro GPU
40 PFLOPSMXFP4-Leistung pro GPU
72 GPUspro AMD Helios Rack

Was ist die AMD Instinct MI400 Serie?

Die AMD Instinct MI400 Serie ist AMDs 2026 eingeführte Generation von Rechenzentrums-GPUs auf Basis der CDNA-5-Architektur. Eingeführt hat AMD die MI455X für KI-Training und Inferenz (432 GB HBM4, 23,3 TB/s, 40 PFLOPS FP4) und die MI430X für HPC und Sovereign AI (bis zu 288 TFLOPS FP64 laut AMD); die MI440X für 8-GPU-Enterprise-Server ist angekündigt. 72 MI455X bilden zusammen das Rack-Scale-System AMD Helios. Für luftgekühlte Bestandsserver gibt es die MI350P aus der MI350-Serie (CDNA 4).

Gelauncht
22./23. Juli 2026 auf der AMD Advancing AI, San Francisco - laut AMD seitdem in Produktion.
Verfügbar über
Systemhersteller, nicht als Einzelkarte - Nelpx liefert über GIGABYTE-Plattformen.
Besonderheit
50 % mehr HBM-Kapazität pro GPU als NVIDIA Vera Rubin (432 vs. 288 GB) und offene Standards statt proprietärem Interconnect.

Stand: 24. Oktober 2026 · Quellen: AMD Newsroom (Launch-PM 23.07.2026, OCP-Keynote 12.10.2026), AMD-Quartalsbericht Q2 2026 (04.08.2026), StorageReview, ServeTheHome, Chips and Cheese - Herstellerclaims sind als solche gekennzeichnet.

Heute bestellbar: AMD Instinct MI355X und MI325X im GIGABYTE-Server. Wer nicht auf die MI400-Generation warten will, bekommt die aktuelle Instinct-Generation als Server mit acht GPUs, luft- oder flüssiggekühlt. Preis und Liefertermin stehen im Angebot. Zu den Servern mit AMD Instinct MI355X und MI325X

Welche MI400-Variante passt zu welchem Workload?

Kurz: MI455X für KI-Fabriken und Rack-Scale-Training, MI440X für Enterprise-Server im Standard-Rack, MI430X für HPC und Sovereign AI mit voller FP64-Leistung, MI350P (MI350-Serie) für luftgekühlte Bestandsserver. Alle Varianten im Detail:

Frontier AI · Helios-Rack

AMD Instinct MI455X

Die Flaggschiff-GPU der Serie: erste GPU mit Compute-Dies im 2-nm-Prozess (TSMC N2), 320 Mrd. Transistoren in 12 Chiplets, 432 GB HBM4 mit 23,3 TB/s. Ausgelegt auf Training und Inferenz größter Modelle - flüssigkeitsgekühlt im Helios-Rack mit 72 GPUs oder in OEM-Systemen.

Ideal für: KI-Fabriken, Training von Frontier-Modellen, speicherintensive LLM-Inferenz mit langen Kontexten, Multi-Tenant-Plattformen (SR-IOV, bis 8 Partitionen pro GPU).

ArchitekturCDNA 5 · 2-nm-Compute-Dies (TSMC N2)
Speicher432 GB HBM4 · 23,3 TB/s
MXFP4 / MXFP840,26 / 20,13 PFLOPS
FP16/BF165,03 PFLOPS
Scale-up / Scale-out3,6 TB/s (UALink) · 2,4 Tbit/s
KühlungDirect Liquid Cooling
Verfügbarkeitin Produktion, Hochlauf ab 2H 2026 - Termin im Angebot
Enterprise · Standard-Rack

AMD Instinct MI440X

Die Enterprise-Plattform der MI400-Serie: 8× MI440X mit einer EPYC-„Venice“-CPU in klassischen Rack-Servern - gedacht für On-Premise-KI in Unternehmen und regulierten Branchen, ohne Umstieg auf Rack-Scale-Infrastruktur. Beim Launch im Juli 2026 war die MI440X nicht dabei; Spezifikationen und Liefertermin hat AMD noch nicht veröffentlicht.

Ideal für: On-Premise-Inferenz und Fine-Tuning im Unternehmens-Rechenzentrum, Abteilungs-Cluster, regulierte Branchen mit Datenhoheits-Anforderungen.

ArchitekturCDNA 5
Plattform8× MI440X + 1× EPYC „Venice“
FormfaktorStandard-Rack-Server (OEM)
Detail-Specskeine offiziellen Compute-Specs - auf Anfrage
Verfügbarkeitvon AMD noch nicht terminiert (angekündigt auf der CES 2026)
HPC · Sovereign AI

AMD Instinct MI430X

Die HPC-Variante mit echter FP64-Hardware: bis zu 288 TFLOPS Double-Precision (AMD-Angabe) bei 432 GB HBM4 - für wissenschaftliches Rechnen, Behörden und nationale KI-Infrastruktur. Design-Wins: der EuroHPC-Exascale-Rechner Alice Recoque (Frankreich) und das ORNL-System Discovery (USA).

Ideal für: Simulation & wissenschaftliches HPC, EuroHPC-/Forschungsprojekte, Sovereign-AI-Programme, gemischte HPC+KI-Workloads.

ArchitekturCDNA 5 · volle FP64/FP32-Hardware
FP64bis 288 TFLOPS (AMD-Angabe)
Speicher432 GB HBM4 · 23,3 TB/s
Plattformmit EPYC „Venice“ (Venice-X ab 2027)
ReferenzenAlice Recoque (EuroHPC) · Discovery (ORNL)
Verfügbarkeitlaut AMD ab 2027, Systeme projektbezogen
Enterprise · Luftgekühlt · PCIe

AMD Instinct MI350P

Die Einstiegskarte für KI im Bestand: luftgekühlte Dual-Slot-PCIe-Karte (CDNA 4) mit 144 GB HBM3E - für luftgekühlte Standard-Server, ohne Flüssigkühlung oder neue Rack-Infrastruktur. GIGABYTE nennt für den G494-ZB0-AAP2 (4 HE) eine bedingte Unterstützung von 8 Karten bei 25 °C Umgebungstemperatur.

Ideal für: LLM-Inferenz und RAG im bestehenden Rechenzentrum, Einstieg in On-Premise-KI, Edge- und Abteilungsserver mit bis zu 8 Karten pro Chassis.

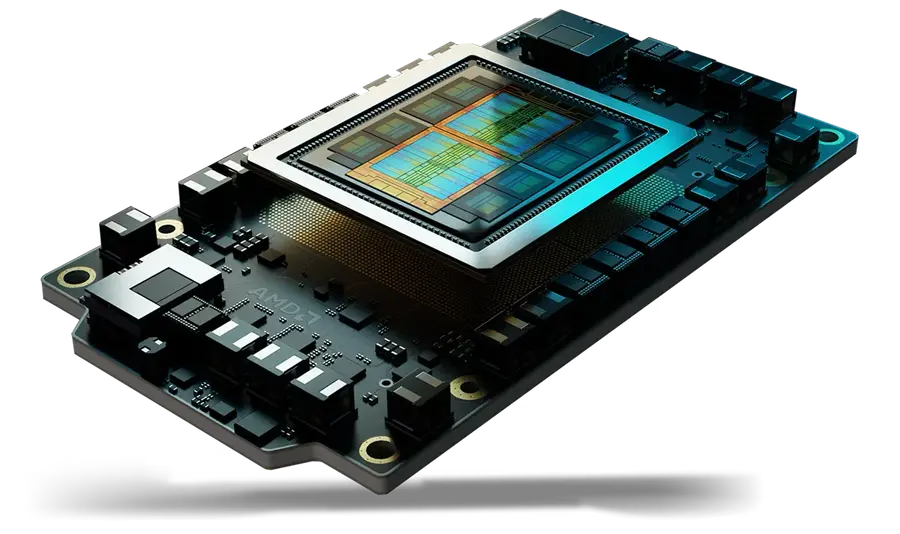
AMD Instinct MI350 Beschleuniger in Bare-Die-Ansicht mit CDNA-4-Chiplets und HBM3E-Speicherstacks
AMD Instinct MI350-Silizium - CDNA-4-Chiplets mit HBM3E, Basis der luftgekühlten MI350P.
ArchitekturCDNA 4 (MI350-Serie)
Speicher144 GB HBM3E · bis 4,0 TB/s
MXFP4bis 4,6 PFLOPS (Peak)
Leistungsaufnahme600 W (450 W konfigurierbar) · Luft
FormfaktorPCIe Gen5 x16, Dual-Slot FHFL
VerfügbarkeitMarktstart 07.05.2026 · über GIGABYTE bestellbar, Preis und Liefertermin im Angebot
CDNA 5

AMDs Compute-Architektur der MI400-Generation: Chiplet-Design aus bis zu 8 Compute-Dies (2 nm) plus I/O- und Cache-Dies, optimiert für Matrix-Formate von FP64 bis MXFP4.

HBM4

High Bandwidth Memory der 4. Generation: gestapelte Speicherchips direkt neben der GPU. Die MI455X erreicht mit 12 Stacks 432 GB Kapazität und 23,3 TB/s Bandbreite.

UALink / UALoE

Offener Industriestandard für GPU-zu-GPU-Verbindungen (Scale-up). Helios tunnelt UALink über Standard-Ethernet („UALoE“) - statt eines proprietären Interconnects.

Sovereign AI

KI-Infrastruktur unter eigener Kontrolle: Hardware, Daten und Modelle bleiben im eigenen Land bzw. Rechenzentrum - Grundlage für datenschutzsensible und behördliche KI-Projekte.

AMD Instinct MI455X: Specs im Vergleich zu NVIDIA

Die MI455X bietet 432 GB HBM4 pro GPU - 50 % mehr als NVIDIA Vera Rubin (288 GB) und 60 % mehr als die heute verfügbare B300 im HGX B300 (270 GB HBM3e laut NVIDIA-Datenblatt). Bei der Bandbreite liegt die MI455X mit 23,3 TB/s rund 21 % vor der Rubin-GPU im Vera Rubin NVL72 (19,2 TB/s laut NVIDIA, Stand Oktober 2026).

HBM-Kapazität pro GPU

GB pro Beschleuniger - mehr Speicher = größere Modelle und längere Kontexte pro GPU

AMD MI455X432 GB HBM4
NVIDIA Rubin (VR200)288 GB HBM4
NVIDIA B300 (HGX B300)270 GB HBM3e

Speicherbandbreite pro GPU

TB/s - entscheidend für Inferenz-Durchsatz speichergebundener LLMs

AMD MI455X23,3 TB/s
NVIDIA Rubin (VR200)19,2 TB/s¹
NVIDIA B300 (HGX B300)7,7 TB/s

FP4-Rechenleistung pro Rack

EFLOPS - AMD MXFP4 vs. NVIDIA NVFP4; Formate nicht 1:1 vergleichbar

NVL72 - Inferenz3,6 EF (NVFP4, sparse)
AMD Helios2,9 EF (MXFP4)
NVL72 - Training2,5 EF (NVFP4, dense)
GB300 NVL721,1 EF (dense)

Scale-up-Bandbreite pro Rack

TB/s GPU-zu-GPU - offenes UALink/Ethernet vs. proprietäres NVLink

AMD Helios (UALoE)260 TB/s
Rubin NVL72 (NVLink 6)216 TB/s
GB300 NVL72 (NVLink 5)130 TB/s

¹ Laut NVIDIA-Produktseite des Vera Rubin NVL72 (Stand Oktober 2026): 19,2 TB/s HBM4-Bandbreite und 3 TB/s NVLink je GPU (216 TB/s pro Rack); für das HGX Rubin NVL8 nennt NVIDIA im Vera-Rubin-Datenblatt 130 TB/s HBM4-Bandbreite pro System (8 GPUs) und 3 TB/s NVLink zwischen den GPUs. Alle Werte: Herstellerangaben, Stand Oktober 2026 - AMD: Launch-Material Advancing AI 2026; NVIDIA: CES-2026-Material und Produktseiten Vera Rubin NVL72 und HGX; B300 im HGX B300 mit 270 GB und 7,7 TB/s je GPU laut NVIDIA-Blackwell-Ultra-Datenblatt (NVIDIAs Entwicklerblog und die Referenzarchitektur nennen 288 GB verbauten Speicher je GPU). FP4-Werte beziehen sich auf unterschiedliche Zahlenformate (MXFP4 vs. NVFP4).

Alle technischen Daten der MI400-Serie anzeigen
SpezifikationMI455XMI430XMI440XMI350P
ArchitekturCDNA 5CDNA 5CDNA 5CDNA 4
FertigungTSMC N2 (Compute-Dies) + N3 (I/O/Cache), 12 Chiplets, 320 Mrd. TransistorenTSMC N2 (Compute-Dies)nicht publiziertTSMC N3 (Compute-Dies)
Speicher432 GB HBM4432 GB HBM4HBM4 (Wert nicht publiziert)144 GB HBM3E
Bandbreite23,3 TB/s23,3 TB/snicht publiziert4,0 TB/s (Peak)
MXFP440,26 PFLOPSbis 9,2 PFLOPS (AMD-Angabe)nicht publiziert4,6 PFLOPS (Peak)
MXFP820,13 PFLOPSnicht publiziertnicht publiziert2,3 PFLOPS (Peak)
FP16/BF165,03 PFLOPSnicht publiziertnicht publiziert1,15 PFLOPS (Peak)
FP645 TFLOPS (Fokus Low-Precision)bis 288 TFLOPS (AMD-Angabe)nicht publiziert36 TFLOPS
PartitionierungSR-IOV, bis 8 Partitionen; NPS1/NPS2SR-IOV (CDNA 5)SR-IOV (CDNA 5)SR-IOV
Scale-upUALink/UALoE, 3,6 TB/s pro GPU, AES-256-GCMInfinity Fabric / Plattform8-GPU-PlattformPCIe Gen5 (kein GPU-Fabric)
Scale-out2,4 Tbit/s pro GPU (3× Pensando „Vulcano“ 800G)projektabhängigprojektabhängigüber Host-NICs
KühlungDirect Liquid CoolingDLC (systemabhängig)Standard-Server (OEM)Luft, Dual-Slot PCIe
Leistungsaufnahmenicht publiziert (Helios-Rack: 225-245 kW)nicht publiziertnicht publiziert600 W (450 W konfigurierbar)
EinsatzFrontier-KI, Helios-RackHPC, Sovereign AIEnterprise-ServerBestandsserver, Inferenz
VerfügbarkeitHochlauf ab 2H 20262027 (laut AMD)noch nicht terminiertMarktstart 07.05.2026, über GIGABYTE bestellbar
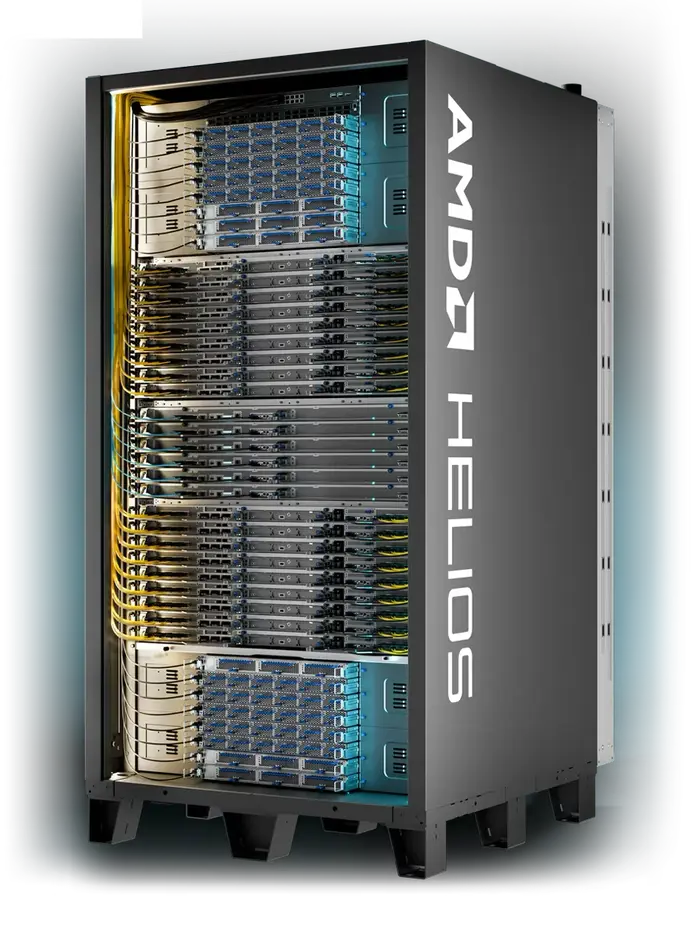
AMD Helios Rack mit 72 Instinct MI455X GPUs, flüssigkeitsgekühlt im Open Rack Wide Formfaktor

AMD Helios Rack: 72× MI455X als komplette KI-Fabrik

AMD Helios ist das Rack-Scale-System der MI400-Generation: 72 MI455X-GPUs und 18 EPYC-„Venice“-CPUs in einem vollständig flüssigkeitsgekühlten Open-Rack-Wide-Schrank - mit 31 TB HBM4 und 2,9 EFLOPS FP4-Leistung pro Rack.

31 TBHBM4 pro Rack
2,9 EFLOPSMXFP4-Leistung
260 TB/sScale-up (UALink über Ethernet)
320 Mrd.Transistoren pro MI455X

Statt eines proprietären Interconnects nutzt Helios offene Standards: UALink als Scale-up-Protokoll, getunnelt über Standard-Ethernet (UALoE), plus 800G-Ethernet-Scale-out über Pensando-„Vulcano“-NICs. Das Rack (ca. 1,2 m breit, 225-245 kW, Direct Liquid Cooling) wird von Systemherstellern gebaut. Laut AMD liefert Helios bis zu 30 % mehr Tokens pro Dollar als NVIDIAs Vera Rubin NVL72 - ein Herstellerbenchmark (Kimi K2 Thinking, 32K/8K-Kontext), den wir entsprechend einordnen.

OpenAI · 6 GWOracle OCI · 50.000 GPUsMeta · 6 GWAnthropic · 2 GWMicrosoft Azure

Öffentlich angekündigte Instinct-Abkommen (AMD-Pressemitteilungen 2025/2026; bei OpenAI und Meta über mehrere GPU-Generationen, die erste Stufe mit MI450/Helios) - Kontingente für den Mittelstand sind entsprechend begrenzt.

Helios-Projekt anfragen

KI-Infrastruktur on-premise: Datenhoheit statt Cloud-Abhängigkeit

MI400-Systeme laufen vollständig im eigenen Rechenzentrum - Trainingsdaten, Prompts und Modelle verlassen die eigene Infrastruktur nicht. DSGVO und KI-Verordnung erfüllt ein eigener Server aber nicht automatisch; die Pflichten des Betreibers bleiben bestehen (Details: KI-Server für Unternehmen).

  • On-Premise = Datenhoheit: Daten und Modelle bleiben im eigenen Rechenzentrum, volle Kontrolle über Datenflüsse und Modellzugriff.
  • Hardware-Sicherheit: Secure Boot und per AES-256-GCM verschlüsselte GPU-zu-GPU-Verbindungen über die UALoE-Fabric (AMD-Angabe zur MI400-Plattform).
  • Mandantentrennung: SR-IOV-Partitionierung - eine MI455X lässt sich in bis zu 8 isolierte Instanzen für Teams oder Mandanten aufteilen.
  • Referenz Europa: Die MI430X treibt „Alice Recoque“ an - Frankreichs ersten Exascale-Supercomputer im EuroHPC-Programm (Bull, vormals Eviden, BullSequana XH3500; Ziel über 1 EFLOPS bei unter 15 MW).
  • Beschaffung über Nelpx: Nelpx liefert AMD-Instinct-Systeme über GIGABYTE-Plattformen, EU-weit. Preis und Liefertermin stehen im Angebot.
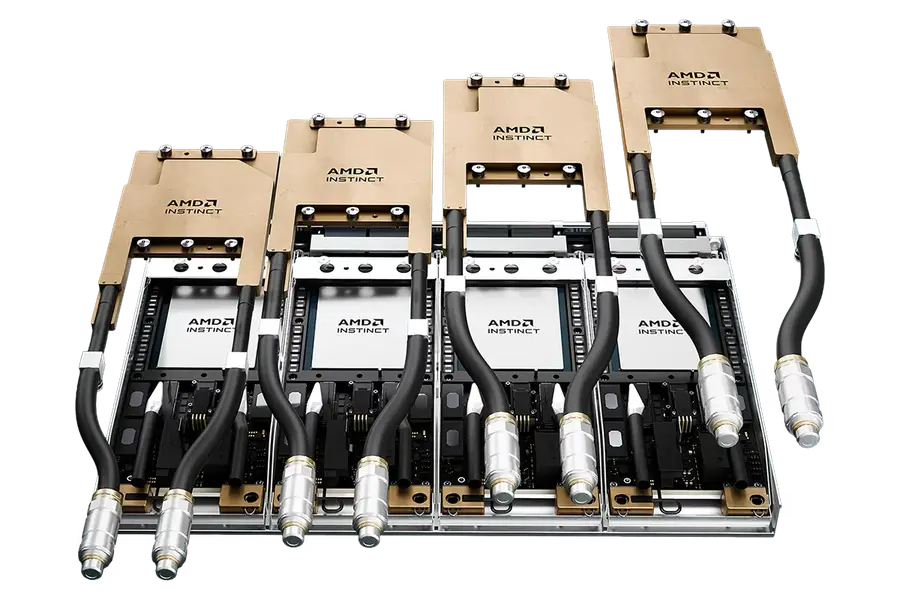
AMD Instinct MI430X GPUs mit Flüssigkühlung auf Universal Baseboard für HPC und Sovereign AI Server
AMD Instinct MI430X - flüssigkeitsgekühlte Module für HPC- und Sovereign-AI-Systeme.

Wofür lohnt sich die AMD Instinct MI400?

Vier typische Projektprofile - und welche Instinct-Variante dafür die richtige ist:

01 LLM-Inferenz on-premise

432 GB HBM4 pro GPU halten große Modelle mit langen Kontexten ohne Sharding im Speicher - weniger GPUs pro Modellinstanz, einfacheres Serving mit vLLM oder SGLang.

MI455X · MI440X
02 Training & Fine-Tuning

40 PFLOPS MXFP4 pro GPU, 2,9 EFLOPS pro Helios-Rack und offenes 800G-Ethernet-Scale-out - für Foundation-Model-Training und Fine-Tuning-Cluster.

MI455X · Helios
03 Wissenschaftliches HPC

Bis zu 288 TFLOPS FP64 (AMD-Angabe) für Simulation, CFD und Forschung - die Architektur hinter EuroHPC-Exascale-Systemen und dem ORNL-Rechner „Discovery“.

MI430X
04 Enterprise-KI im Bestand

Die luftgekühlte MI350P (PCIe, 144 GB HBM3E) bringt Inferenz und RAG in luftgekühlte Standard-Server, bei GIGABYTE im G494-ZB0-AAP2 - ohne Flüssigkühlung.

MI350P

Wann ist die AMD Instinct MI400 verfügbar?

Die MI400-Serie ist laut AMD seit dem Launch am 23. Juli 2026 in Produktion. Am 12. Oktober 2026 hat AMD bestätigt, dass Helios-Kundenauslieferungen, Deployments und Workload-Validierungen laufen; erste Systeme sind bei OpenAI, Meta, Microsoft und Oracle installiert und in Betrieb. Der breite Hochlauf folgt ab Q4 2026, den konkreten Liefertermin bestätigen wir im Angebot. Wegen der Hyperscaler-Großabnahmen empfiehlt sich für 2026/2027-Projekte eine frühzeitige Allokations-Reservierung.

Juli 2026Launch & Produktion

Offizieller Launch auf der Advancing AI 2026 (22./23.07.) - MI455X und Helios „in voller Produktion“.

Ende Q3 2026Erste Auslieferungen

Laut AMD (Quartalszahlen 04.08.2026) beginnen erste Helios-Auslieferungen; am 12.10.2026 hat AMD laufende Kundenauslieferungen bestätigt, erste Systeme laufen bei OpenAI, Meta, Microsoft und Oracle. Oracle OCI hatte den ersten öffentlichen MI450-Supercluster (50.000 GPUs) ab Q3 2026 angekündigt.

Q4 2026OEM- & Venice-Rollout

EPYC-„Venice“-Systeme (Zen 6, PCIe Gen6) kommen von den OEMs; erste Helios-Systeme laufen laut AMD bereits, u. a. bei OpenAI; für die MI440X hat AMD noch keinen Termin genannt.

2027Ramp & Ausblick

Breiter Hochlauf (u. a. Anthropic ab H1 2027); MI430X-Systeme laut AMD ab 2027, projektbezogen; AMD hat die Nachfolge-Serie MI500 für 2027 angekündigt.

1Anfrage

Workload, Variante (MI455X, MI440X, MI430X, MI350P oder Helios), Stückzahl und Zeitrahmen formlos an sales@nelpx.de - oder direkt über den Anfrage-Button.

2Konfiguration & Angebot

Nelpx prüft Verfügbarkeit und Allokation über GIGABYTE, konfiguriert das System und nennt Preis und Liefertermin im Angebot.

3Lieferung & Integration

Lieferung, Rack-Integration, Netzwerk-Fabric und Inbetriebnahme EU-weit. Direct Liquid Cooling muss am Aufstellort vorhanden sein.

Verfügbarkeit & Lieferzeit anfragen

MI455X vs. NVIDIA Vera Rubin im Vergleich

Kurzfassung: AMD gewinnt bei Speicherkapazität und offenen Standards, NVIDIA beim Software-Ökosystem und beim FP4-Inferenz-Spitzenwert pro Rack. Welche Plattform wirtschaftlicher ist, entscheidet der konkrete Workload - nicht das Datenblatt.

Das spricht für AMD MI400

  • +50 % HBM-Kapazität: 432 vs. 288 GB pro GPU - weniger GPUs pro Modellinstanz bei großen LLMs.
  • Offene Standards: UALink über Ethernet statt proprietärem NVLink - keine Vendor-Lock-in-Fabric, Standard-Netzwerktechnik.
  • Preis-Leistung: laut AMD bis zu 30 % mehr Tokens pro Dollar als Vera Rubin NVL72 (Herstellerbenchmark).
  • Ökosystem-Rückenwind: OpenAI (6 GW), Meta (6 GW), Anthropic (2 GW), Oracle und Microsoft Azure setzen öffentlich auf Instinct - das treibt die ROCm-Software-Reife messbar.
  • FP64-Führung: Die MI430X zielt mit bis zu 288 TFLOPS FP64 (AMD-Angabe) klar auf HPC - ein Segment, das NVIDIA mit Rubin depriorisiert.

Das spricht für NVIDIA

  • CUDA-Ökosystem: größte Software-Basis, die meisten Frameworks und Tools sind CUDA-first; bestehender CUDA-Code erfordert bei AMD Portierung.
  • FP4-Inferenz-Peak: der Vera Rubin NVL72 nennt 3,6 EFLOPS NVFP4-Inferenz pro Rack (Sparse-Angabe) - über Helios' 2,9 EFLOPS MXFP4 (bei Training, dense: 2,5 EF, unter Helios).
  • Verfügbarkeit heute: B300/GB300-Systeme sind jetzt lieferbar - wer sofort Kapazität braucht, findet dort ein ausgereiftes Angebot (siehe HGX B300 und GB300 NVL72).
  • Betriebserfahrung: mehr produktive Großdeployments, mehr Referenzarchitekturen, mehr geschultes Personal am Markt.

Nelpx liefert sowohl NVIDIA- (HGX B200, HGX B300, Vera Rubin NVL72, GIGAPOD mit HGX Rubin NVL8) als auch AMD-Instinct-Systeme über GIGABYTE-Plattformen - die Wahl richtet sich nach Workload, Software-Stack, Facility und Budget, nicht nach dem Logo. Heute bestellbar: AMD Instinct MI355X und MI325X im GIGABYTE-Server.

Häufige Fragen zur AMD Instinct MI400

Wo kann ich die AMD Instinct MI400 in Deutschland kaufen?

AMD vertreibt die Instinct-MI400-Serie über Systemhersteller - nicht einzeln an Endkunden. Nelpx liefert AMD-Instinct-Systeme über GIGABYTE-Plattformen, EU-weit; Verfügbarkeit, Preis und Liefertermin der MI400-Systeme stehen im Angebot. Heute bestellbar sind AMD Instinct MI355X und MI325X im GIGABYTE-Server. Eine Anfrage an sales@nelpx.de genügt.

Was kostet die AMD Instinct MI455X?

AMD veröffentlicht keine Listenpreise für die MI400-Serie. Die Preise hängen von Variante, Stückzahl, Systemkonfiguration und Marktlage ab; kursierende Zahlen sind Analysten-Schätzungen. Nelpx kalkuliert jede Anfrage projektbezogen über GIGABYTE-Plattformen und nennt Preis und Liefertermin im Angebot.

Wann ist die MI400 verfügbar und wie lange sind die Lieferzeiten?

Die MI400-Serie ist laut AMD seit dem Launch am 23. Juli 2026 in Produktion. Am 12. Oktober 2026 hat AMD bestätigt, dass Helios-Kundenauslieferungen, Deployments und Workload-Validierungen laufen; erste Systeme sind bei OpenAI, Meta, Microsoft und Oracle installiert und in Betrieb. Der breite Hochlauf folgt bis ins Jahr 2027. Da Großabnehmer wie OpenAI, Oracle, Meta und Anthropic erhebliche Kontingente gebunden haben, empfiehlt sich für 2026/2027-Projekte eine frühzeitige Reservierung der Allokation über einen Partner wie Nelpx. Den konkreten Liefertermin bestätigen wir im Angebot.

Was ist der Unterschied zwischen MI455X, MI440X und MI430X?

Alle drei basieren auf CDNA 5 mit HBM4. Die MI455X (432 GB, 23,3 TB/s, 40 PFLOPS FP4) ist die flüssigkeitsgekühlte Flaggschiff-GPU für Training und Inferenz im Helios-Rack. Die MI440X ist die Enterprise-Variante für klassische 8-GPU-Server im Standard-Rack. Die MI430X ist auf HPC und Sovereign AI ausgelegt - bis zu 288 TFLOPS Hardware-FP64 (AMD-Angabe), im Einsatz beim EuroHPC-Rechner Alice Recoque. Dazu kommt die MI350P als luftgekühlte PCIe-Karte (CDNA 4, 144 GB HBM3E) für Bestandsserver.

Läuft PyTorch bzw. vLLM auf der MI400?

Ja. AMD nennt für die MI455X Day-0-Unterstützung in PyTorch, Hugging Face, vLLM und SGLang auf ROCm-Basis. Produktiveinsätze bei OpenAI, Meta, Microsoft Azure und Oracle sowie Anthropics ROCm-Engagement stützen die Software-Reife. Für CUDA-Bestandscode ist Portierungsaufwand einzuplanen.

Wie schlägt sich die MI455X gegen NVIDIA Vera Rubin?

Die MI455X bietet 432 GB HBM4 gegenüber 288 GB bei Vera Rubin - 50 % mehr Speicher - bei 23,3 TB/s Bandbreite (Rubin im NVL72: 19,2 TB/s). Auf Rack-Ebene liegt Helios (2,9 EFLOPS MXFP4) über dem NVFP4-Trainingswert des NVL72 (2,5 EF), aber unter dessen Inferenz-Spitzenwert (3,6 EF, Sparse-Angabe). AMD wirbt mit bis zu 30 % mehr Tokens pro Dollar (Herstellerbenchmark); NVIDIAs Vorteil bleibt das CUDA-Ökosystem. Details in der Vergleichssektion.

Ist die MI400 DSGVO-konform on-premise betreibbar?

MI400-Systeme laufen vollständig on-premise - Daten und Modelle verlassen die eigene Infrastruktur nicht. DSGVO und KI-Verordnung erfüllt ein eigener Server aber nicht automatisch; die Pflichten des Betreibers bleiben bestehen (Details: KI-Server für Unternehmen). Das ist keine Rechtsberatung. Die Plattform bietet Secure Boot, AES-256-GCM-verschlüsselte GPU-zu-GPU-Links und SR-IOV-Partitionierung für Mandantentrennung.

Lässt sich die MI455X partitionieren (Multi-Tenant-Betrieb)?

Ja. Die MI455X unterstützt SR-IOV mit bis zu 8 Partitionen pro GPU sowie die Speichermodi NPS1/NPS2. Eine GPU mit 432 GB HBM4 lässt sich so in isolierte Instanzen für mehrere Teams, Mandanten oder Workloads aufteilen - relevant für interne KI-Plattformen und Service-Provider.

Welche Kühlung und Stromversorgung braucht ein Helios-Rack?

Das Helios-Rack ist vollständig flüssigkeitsgekühlt (Direct Liquid Cooling, ca. 385 l/min) und nimmt 225-245 kW pro Rack auf - die Facility muss dafür ausgelegt sein. Der Formfaktor ist Open Rack Wide (ca. 1,2 m breit). Ohne DLC-Infrastruktur sind die luftgekühlte MI350P oder die MI440X-Plattform die Alternativen; heute bestellbar ist außerdem die AMD Instinct MI355X im luftgekühlten GIGABYTE-Server.

Lohnt es sich, auf die AMD Instinct MI500 zu warten?

Die MI500-Serie ist für 2027 angekündigt, ohne konkrete Specs und Termine. Wer 2026/2027 Kapazität braucht, plant realistisch mit der MI400-Generation - zumal Allokationen knapp sind und ein Generationswechsel im selben ROCm-Stack später möglich bleibt.
Sichern Sie sich Ihre MI400-Allokation

Die ersten MI455X- und Helios-Kontingente sind durch Hyperscaler-Deals weitgehend gebunden. Wer 2026/2027 AMD-Instinct-Kapazität plant, sollte jetzt reservieren - Nelpx prüft Verfügbarkeit, konfiguriert und liefert.

Jetzt Verfügbarkeit anfragen

Angebot projektbezogen · EU-weite Lieferung & Integration