
NVIDIA HGX H200 kaufen - 8× H200 SXM, frei konfigurierbar
Die bewährte Hopper-Plattform als offener 8-GPU-Server: 1,1 TB HBM3e, alle GPUs über NVSwitch mit je 900 GB/s verbunden, luftgekühlt in 5U als GIGABYTE G593. CPU, RAM, Storage und Fabric wählen Sie selbst - wir konfigurieren, beschaffen und integrieren über den direkten Herstellerkanal.
IT-Systemhaus für HPC & AI-Infrastruktur · Lieferung EU-weit · Direkter Herstellerkanal
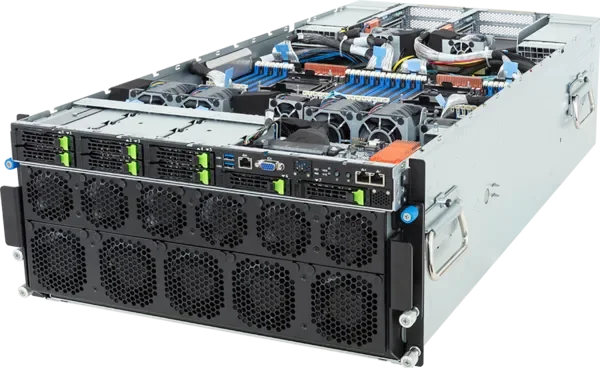
Was ist der NVIDIA HGX H200?
Der NVIDIA HGX H200 ist NVIDIAs H200-Serverboard der Hopper-Generation in der 8-GPU-Ausbaustufe: 8 H200-SXM-GPUs mit zusammen 1.128 GB HBM3e (141 GB je GPU, 4,8 TB/s), untereinander über NVSwitch mit 900 GB/s je GPU verbunden. Serverhersteller wie GIGABYTE bauen daraus komplette Systeme - luftgekühlt im 5U-Format (G593-Serie) oder flüssigkeitsgekühlt als DLC-Variante. CPU, RAM, Storage und Netzwerk sind frei konfigurierbar. Nelpx liefert HGX-H200-Systeme als offizieller GIGABYTE-Partner EU-weit; der Preis ist konfigurationsabhängig - Preis und Liefertermin bestätigt Nelpx im Angebot.
- Verfügbarkeit
- Restverfügbarkeit: Die H200-Fertigung wurde Medienberichten zufolge im März 2026 gestoppt und primär für China-Aufträge wieder angefahren (Pressestand, kein NVIDIA-Dokument) - der EU-Kanal läuft über Bestand und OEM-Allokation. Nelpx prüft Slots direkt beim Hersteller.
- Kernvorteil
- Läuft luftgekühlt im Bestands-Rechenzentrum (GIGABYTE G593: 5U, 10 bis 35 °C Betriebstemperatur) und fährt Modelle bis DeepSeek-R1 671B FP8 auf einem einzigen System.
- Gegenüber Blackwell
- Ausgereifter FP8-Stack, luftgekühlt in 5U, deutlich stärkere FP64-Leistung als der B300 (10 TFLOPS je System laut NVIDIA) - dafür kein FP4 und weniger Speicher.
Stand: 5. Oktober 2026 · Quellen: NVIDIA-Produktseite/Pressemitteilung und H200-Datenblatt, GIGABYTE-Produktseiten G593 und GIGAPOD, NVIDIA-Entwicklerblog, Presseberichte zur Fertigung - Herstellerclaims sind gekennzeichnet.
GIGABYTE G593: zwei CPU-Basen, Luft oder DLC
Anders als beim fest definierten DGX wählen Sie beim G593 die Host-Plattform passend zu Workload und Software-Stack - Intel oder AMD, Luft- oder Flüssigkühlung:
Bis 12-Kanal-DDR5 (24 DIMM-Slots), hohe Kernzahlen und ein starkes Preis-Leistungs-Profil - und aktuell deutlich kurzfristiger lieferbar als die Intel-Basis. Unsere Empfehlung.
32 DIMM-Slots (8-Kanal je CPU, DDR5 bis 5600 MT/s) und bis 4 TB RAM - der Speicher-Champion. Wichtig: Intel-Xeon-CPUs haben aktuell sehr lange Lieferzeiten (Stand August 2026).
Gleiche Plattform mit Kaltplatten auf CPU und GPU - laut GIGABYTE bis 64 GPUs (8 Server) je Rack, ausgelegt für 100 kW IT-Last. Für alle, die Dichte und Kühleffizienz maximieren wollen.
Quellen: GIGABYTE-Produktseiten G593-SD1-AAX3, G593-ZD1-AAX3 und G593-SD1-LAX3 sowie GIGABYTE-Pressemitteilungen. Betriebssysteme: u. a. Ubuntu LTS und RHEL mit CUDA-Stack - Freigabe je Konfiguration.
HGX H200 konfigurieren
Referenzwerte sind voreingestellt - jede Position anpassbar. Als PDF herunterladen oder direkt an uns senden.
= 8 GPUs · 1.128 GB HBM3e
Hinweis: Intel-Xeon-CPUs haben aktuell sehr lange Lieferzeiten (Stand August 2026) - wir empfehlen die AMD-EPYC-Basis. Konkrete Liefertermine prüfen wir im Angebot.
Hinweis: Mit BlueField-3 nennt GIGABYTE für den luftgekühlten G593-ZD1 max. 30 °C Umgebungstemperatur (ggf. angepasster PCIe-Einschub), für die DLC-Variante ZD1-LAX3 max. 25 °C - Details klären wir im Angebot.
Konfiguration und Kontaktdaten bleiben beim Ausfüllen vollständig in Ihrem Browser - Daten werden erst beim aktiven Absenden der E-Mail übertragen. Datenschutzerklärung
HGX H200 in Zahlen
Was passt in 1.128 GB GPU-Speicher, wo steht der H200 gegenüber H100 und Blackwell - und wo gewinnt er sogar gegen den B300:
Quellen: NVIDIA-Produktseiten (H200/HGX/NVLink), NVIDIA-Entwicklerblog (DeepSeek-R1, Llama 405B), MLPerf Inference v5.0 (Llama 2 70B Offline, 8× B200 gegen 8× H200, Einreicher NVIDIA), Modellgrößen via Hugging Face. NVIDIA gibt Tensor-Leistung standardmäßig mit Sparsity an - dense-Werte sind explizit ausgewiesen; FP64-Systemwerte je 8 GPUs teils rechnerisch (8× Einzel-GPU).
Alle technischen Daten anzeigen (Plattform + GIGABYTE G593)
| Spezifikation | NVIDIA HGX H200 im GIGABYTE G593 |
|---|---|
| GPUs | 8× NVIDIA H200 SXM (Hopper) · Tensor-Cores 4. Gen · bis 700 W je GPU (konfigurierbar) |
| GPU-Speicher | 1.128 GB HBM3e gesamt (141 GB je GPU) · 4,8 TB/s je GPU (rechnerisch 38,4 TB/s aggregiert) |
| Rechenleistung (System) | FP8: ~32 PFLOPS mit Sparsity / ~15,8 dense · FP16/BF16: ~15,8 / ~7,9 · TF32: ~7,9 / ~4 · FP64: 272 TFLOPS · FP64-Tensor-Core: 536 TFLOPS (rechnerisch 8× 34 bzw. 8× 67) |
| NVLink / NVSwitch | NVLink 4: 900 GB/s je GPU · 4× NVSwitch (3. Gen), jede GPU mit jeder voll vernetzt |
| MIG | Bis 7 Instanzen à 18 GB je GPU - bis 56 Partitionen pro System |
| Scale-out | Bis 8× 400G als Steckkarten (ConnectX-7 / BlueField-3) - InfiniBand NDR oder 400GbE, 1 NIC je GPU möglich |
| CPUs (wählbar) | 2× Intel Xeon Scalable 5./4. Gen (SD1, 32 DIMMs, bis 4 TB) oder 2× AMD EPYC 9005/9004 (ZD1, 24 DIMMs, bis 3 TB) |
| Storage | 8× 2,5" Gen5-NVMe hot-swap + M.2 (OS) |
| Erweiterung | 12× PCIe Gen5 x16 (4× FHHL + 8× LP) · 2× 10GbE Host-LAN onboard |
| Strom / Kühlung | 6× 3.000-W-Titanium-PSUs (redundant, 4+2 bzw. 5+1 je Variante) · Luftkühlung, 10 bis 35 °C Betriebstemperatur laut GIGABYTE · alternativ DLC (LAX3, CPU+GPU-Kaltplatten) |
| Formfaktor | 5U · 447 × 219,7 × 945 mm · ca. 88 bis 91 kg netto |
| Rack-Skalierung | DLC: bis 64 GPUs (8 Server) je Rack, ausgelegt für 100 kW IT-Last (GIGABYTE-Pressemitteilung zur G593-LAX3) · Luft: Stückzahl je Rack nach Strombudget - die Rackbelegung planen wir mit Ihnen |
| Software | Betriebssystem nach Kundenwunsch (Linux-Distributionen mit CUDA-Stack, Freigabe je Konfiguration laut GIGABYTE) · NVIDIA AI Enterprise als Add-on (bei SXM nicht enthalten) |
| Verfügbarkeit | Restverfügbarkeit aus Bestand und OEM-Allokation (Pressestand, kein NVIDIA-Dokument: Fertigung im März 2026 gestoppt, kurz darauf Neustart für China-Aufträge; eine Abkündigung haben wir nicht gefunden) - Slots über den GIGABYTE-Partnerkanal |
Vom Einzelserver zum Cluster
Der HGX H200 wächst mit: bis zu 8 400G-Ports pro System verbinden jede GPU mit dem Cluster - als InfiniBand- oder Ethernet-Fabric. Mehr dazu auf der Seite KI-Cluster kaufen.
Das Fabric liefern wir gleich mit: Als PNY-Partner beziehen wir das NVIDIA-Netzwerk über den offiziellen Distributionskanal - Switches, NICs und Kabel aus einer Hand, auf die ConnectX-7-Anbindung des HGX H200 abgestimmt. Preis auf Anfrage im Angebot.
Konfiguration, Allokationsprüfung und Lieferung laufen direkt über den Herstellerkanal - mit kurzen Wegen bei Kontingenten, Ersatzteilen und Eskalationen. Gerade bei Restverfügbarkeit zählt der direkte Draht. Und als PNY-Partner liefern wir das NVIDIA-Netzwerk gleich mit - Server und Fabric aus einer Hand.
Wofür lohnt sich der HGX H200 im Jahr 2026?
DeepSeek-R1 671B läuft in FP8 komplett auf einem System - von NVIDIA offiziell demonstriert. Llama 3.1 405B FP8 ist das Referenz-Deployment auf 8× H200. Kein Multi-Node-Sharding, keine Fabric-Komplexität.
CFD, FEM, Molekulardynamik: Mit rechnerisch 536 TFLOPS über den FP64-Tensor-Core-Pfad (reines FP64: 272 TFLOPS) pro System liegt der H200 weit vor dem B300 (10 TFLOPS je System laut NVIDIA) - Blackwell Ultra ist auf KI-Formate spezialisiert, Hopper bleibt die HPC-Wahl.
DSGVO-konforme LLM-Plattformen im eigenen Rechenzentrum: Prompts bleiben im eigenen Netz, die größten offenen Modelle passen komplett in die 1,1 TB GPU-Speicher.
Luftgekühlt in 5U statt Facility-Umbau: Der G593 ist bis 35 °C Betriebstemperatur spezifiziert und läuft in der vorhandenen Kaltgang-Einhausung - die luftgekühlten Blackwell-Server von GIGABYTE brauchen 8U und sind bis 30 °C spezifiziert.
8 GPUs mit je 141 GB lassen sich per MIG in bis zu 56 Instanzen à 18 GB partitionieren - eine Anschaffung, viele Teams, saubere Isolation.
Der am längsten gereifte Software-Stack (CUDA, vLLM, TensorRT-LLM) mit FP8 als kleinstem Format. Wer FP4 nicht braucht, bekommt mit Hopper eine erprobte Plattform - den Preis nennen wir im Angebot.
HGX H200, H200 NVL, HGX B200 oder B300?
Wann der HGX H200 passt - und wann ein anderes System die bessere Wahl ist.
Gründe für den HGX H200
- 1,1 TB reichen weit: DeepSeek-R1 671B und Llama 405B laufen in FP8 auf einem einzigen System - NVSwitch verbindet alle 8 GPUs mit je 900 GB/s.
- Bestands-RZ-tauglich: luftgekühlt in 5U, bis 35 °C Betriebstemperatur - kein Facility-Umbau, keine Flüssigkühlungs-Pflicht.
- FP64-HPC: rechnerisch 536 TFLOPS pro System über den Tensor-Core-Pfad (reines FP64: 272) - für Simulation und Wissenschaft klar vor Blackwell Ultra (B300: 10 TFLOPS je System).
- Ausgereifter Stack: FP8-Software seit Jahren im Einsatz, ohne Migrationsrisiko.
- Offene Plattform: CPU-Wahl (Intel/AMD), RAM bis 4 TB, freie OS-Wahl, Luft oder DLC - konfigurierbar statt Appliance.
Alternativen
- H200 NVL (PCIe): der flexible Einstieg für Bestandsserver - bis 4 Karten per NVLink-Bridge, inkl. 5 Jahren AI Enterprise (zur H200-NVL-Seite).
- HGX B200: gut doppelte FP8-Leistung und FP4-Support - der Schritt nach vorn, wenn Durchsatz vor Budget geht (zum B200-Konfigurator).
- HGX B300: 2,1 TB HBM3e und 800G-Netzwerk ab Werk - für Reasoning-Workloads und lange Kontexte (zur B300-Seite).
- Rack-Scale und nächste Generation: GB300 NVL72. NVIDIA meldete am 26.08.2026, dass die Vera-Rubin-Plattform in die volle Serienproduktion hochläuft und erste Racks bei Partnern laufen; Kundenprojekte mit Vera Rubin NVL72 planen wir ab H1 2027, das ist unsere Planung und keine Aussage von NVIDIA. Für GIGABYTE-Server mit HGX Rubin NVL8 ist kein Liefertermin veröffentlicht.
- AMD-Alternative: AMD Instinct MI355X und MI325X im GIGABYTE-Server, als Ausblick Instinct MI400.
- Einordnung: NVIDIA B300 und B200 als GPU erklärt und der Vergleich H100, H200, B200 und B300.
- Unsicher? Wir rechnen die Wege im Angebot transparent gegeneinander - inklusive Strom- und Kühlkosten (HGX und DGX im Vergleich).
Häufige Fragen zum NVIDIA HGX H200
Was kostet ein NVIDIA HGX H200 Server?
Der Preis ist konfigurationsabhängig und wird bei Nelpx auf Anfrage kalkuliert. Er hängt von CPU, RAM, Storage, Netzwerk und Stückzahl ab. NVIDIA und GIGABYTE veröffentlichen keine Listenpreise. Nelpx kalkuliert über den GIGABYTE-Partnerkanal und erstellt ein Angebot mit verbindlichem Preis und Liefertermin nach Allokationsprüfung - am schnellsten über den Konfigurator auf dieser Seite.
Ist der HGX H200 noch lieferbar und wie lange dauert die Lieferung?
Ja, aber aus Restverfügbarkeit: Medienberichten zufolge hat NVIDIA die H200-Chipfertigung im März 2026 zugunsten der nächsten Generation gestoppt und einen Neustart vor allem für freigegebene China-Aufträge angekündigt. Das ist der Pressestand, kein NVIDIA-Dokument; eine Abkündigung der H200 haben wir nicht gefunden. Für den europäischen Kanal zählen Bestand und laufende OEM-Allokation. Einzelsysteme sind über Integratoren typischerweise in wenigen Wochen lieferbar, größere Stückzahlen sind allokationsabhängig. Nelpx prüft konkrete Slots direkt im GIGABYTE-Partnerkanal - je früher die Anfrage, desto besser der Termin.
Wo kann man einen NVIDIA HGX H200 kaufen?
Nicht bei NVIDIA direkt: HGX ist eine Plattform, die Serverhersteller wie GIGABYTE in eigene Systeme integrieren - verkauft wird über deren Partner und Systemhäuser. Nelpx liefert HGX-H200-Systeme als offizieller GIGABYTE-Partner EU-weit, inklusive Konfiguration, Integration und Support - auf dieser Seite direkt konfigurierbar.
Lohnt sich der HGX H200 2026 noch - oder besser HGX B200/B300?
Der H200 bleibt 2026 die rationale Wahl, wenn FP8-Inferenz großer Modelle, Luftkühlung im Bestands-Rechenzentrum oder FP64-HPC im Vordergrund stehen: Der Software-Stack ist ausgereift, und bei FP64 liegt der H200 (pro System rechnerisch 272 TFLOPS, über den Tensor-Core-Pfad 536 TFLOPS) weit vor dem B300 (10 TFLOPS je System laut NVIDIA). Wer maximalen Token-Durchsatz mit FP4 oder größten GPU-Speicher braucht, greift zum HGX B200 oder B300 - Nelpx rechnet beide Wege im Angebot gegen.
Was ist der Unterschied zwischen HGX H200 und DGX H200?
Beide nutzen dasselbe 8-GPU-Baseboard mit identischer GPU-Leistung. Der DGX H200 ist NVIDIAs fest definiertes Komplettsystem (2× Xeon Platinum 8480C, 2 TB RAM, DGX OS, NVIDIA-Software inklusive). Ein HGX-H200-Server wie der GIGABYTE G593 ist die offene Variante: CPU wählbar (Intel Xeon oder AMD EPYC), RAM bis 4 TB, Storage und Netzwerk frei konfigurierbar. Nelpx liefert die HGX-Variante von GIGABYTE, das DGX-System bieten wir nicht an.
Was ist der Unterschied zwischen H200 SXM (HGX) und H200 NVL (PCIe)?
Speicher und Bandbreite sind identisch (141 GB HBM3e, 4,8 TB/s je GPU). Die SXM-Version im HGX-System leistet mehr (FP8 3.958 statt 3.341 TFLOPS mit Sparsity, bis 700 statt 600 W) und verbindet alle 8 GPUs über NVSwitch mit je 900 GB/s - beim NVL-PCIe-Format sind maximal 4 Karten per NVLink-Bridge koppelbar. Die NVL-Karte ist dafür der flexible Einstieg für Bestandsserver (zur H200-NVL-Seite). Wichtiger Unterschied bei der Software: Bei der NVL-Karte ist eine 5-Jahres-Subscription von NVIDIA AI Enterprise enthalten, bei SXM-Systemen nicht.
Welche KI-Modelle laufen auf einem HGX H200 mit 1,1 TB HBM3e?
Die 1.128 GB GPU-Speicher reichen für die größten offenen Modelle in FP8: DeepSeek-R1 671B (~685 GB Gewichte) läuft komplett auf einem einzigen System - von NVIDIA offiziell mit bis zu 3.872 Token/s demonstriert. Llama 3.1 405B FP8 (~406 GB) ist NVIDIAs Referenz-Deployment auf 8× H200, Qwen3-235B und Mistral Large passen komfortabel, und Llama 3.3 70B läuft bereits auf einer einzelnen der acht GPUs.
Wie viel schneller ist der H200 als der H100?
NVIDIA nennt für Llama 2 70B bis zu 1,9-fache Inferenzleistung der H200 gegenüber der H100 (Herstellerangabe aus dem H200-Datenblatt, je eine GPU, H200 mit größerer Batch). In MLPerf Inference v5.0 erreichte ein System mit 8× H200 34.988 Token/s (Llama 2 70B Offline, Einreicher NVIDIA). Der Vorsprung kommt vor allem aus dem Speicher: 141 statt 80 GB pro GPU und 4,8 statt 3,35 TB/s Bandbreite. Die Rechenwerte beider GPUs sind laut Datenblatt gleich. Die H100 ist laut Mitteilungen aus Distribution und von Serverherstellern abgekündigt (Stand der Restbestände: NVIDIA H100 kaufen), der H200 ist die verbleibende Hopper-Option.
Wie viel Strom verbraucht ein HGX-H200-Server und welche Kühlung braucht er?
GIGABYTE veröffentlicht für den G593 keinen Verbrauchswert, nur die Netzteile: 6× 3.000 W Titanium, redundant. Die 8 GPUs sind laut NVIDIA mit bis zu 8× 700 W konfigurierbar. Der GIGABYTE G593 ist als luftgekühlter 5U-Server für 10 bis 35 °C Betriebstemperatur spezifiziert und läuft in klassischen Kaltgang-Umgebungen. Für höhere Rack-Dichte gibt es die DLC-Variante (G593-LAX3) mit Kaltplatten auf CPU und GPU - laut GIGABYTE bis 64 GPUs (8 Server) je Rack, ausgelegt für 100 kW IT-Last.
Welche CPUs und wie viel RAM gehören in einen HGX-H200-Server?
Beim GIGABYTE G593 sind zwei Basen wählbar: G593-SD1 mit 2× Intel Xeon Scalable der 4./5. Generation (32 DIMM-Slots, bis 4 TB DDR5) oder G593-ZD1 mit 2× AMD EPYC 9005/9004 (24 DIMM-Slots, bis 3 TB). Bewährter Sweet Spot sind 2 TB RAM - das entspricht der Auslegung von NVIDIAs DGX-Referenz; als CPU-Empfehlung gelten 32 Kerne oder mehr pro Sockel für Daten-Preprocessing neben den GPUs. Wichtig für die Terminplanung: Intel-Xeon-CPUs haben aktuell sehr lange Lieferzeiten (Stand August 2026) - Nelpx empfiehlt daher die kurzfristiger lieferbare AMD-EPYC-Basis G593-ZD1.
Ist NVIDIA AI Enterprise beim HGX H200 enthalten?
Nein - bei H200-SXM-Systemen führt NVIDIA die AI-Enterprise-Suite als kostenpflichtiges Add-on (anders als bei der H200-NVL-PCIe-Karte, wo eine 5-Jahres-Subscription enthalten ist). Der Server läuft alternativ vollständig ohne AI-Enterprise-Lizenz: eine gängige Linux-Distribution mit dem frei verfügbaren CUDA-Stack, dazu Open-Source-Serving wie vLLM, SGLang oder Triton. Nelpx weist Lizenzkosten im Angebot transparent aus, wenn AI Enterprise gewünscht ist.
Ist ein HGX-H200-Server DSGVO-konform betreibbar?
Ja - als On-Premise-System bleiben Trainingsdaten, Prompts und Modelle vollständig in der eigenen Infrastruktur, was DSGVO-Bewertung und EU-AI-Act-Einordnung deutlich vereinfacht. Mit 1,1 TB GPU-Speicher laufen auch die größten offenen Modelle lokal; Nelpx konzipiert die Umgebung inklusive Netzwerk- und Sicherheitsarchitektur.
NVIDIA HGX H200 kaufen - 8× H200 SXM, frei konfigurierbar
Die bewährte Hopper-Plattform als offener 8-GPU-Server: 1,1 TB HBM3e, alle GPUs über NVSwitch mit je 900 GB/s verbunden, luftgekühlt in 5U als GIGABYTE G593. CPU, RAM, Storage und Fabric wählen Sie selbst - wir konfigurieren, beschaffen und integrieren über den direkten Herstellerkanal.
IT-Systemhaus für HPC & AI-Infrastruktur · Lieferung EU-weit · Direkter Herstellerkanal
Was ist der NVIDIA HGX H200?
Der NVIDIA HGX H200 ist NVIDIAs H200-Serverboard der Hopper-Generation in der 8-GPU-Ausbaustufe: 8 H200-SXM-GPUs mit zusammen 1.128 GB HBM3e (141 GB je GPU, 4,8 TB/s), untereinander über NVSwitch mit 900 GB/s je GPU verbunden. Serverhersteller wie GIGABYTE bauen daraus komplette Systeme - luftgekühlt im 5U-Format (G593-Serie) oder flüssigkeitsgekühlt als DLC-Variante. CPU, RAM, Storage und Netzwerk sind frei konfigurierbar. Nelpx liefert HGX-H200-Systeme als offizieller GIGABYTE-Partner EU-weit; der Preis ist konfigurationsabhängig - Preis und Liefertermin bestätigt Nelpx im Angebot.
- Verfügbarkeit
- Restverfügbarkeit: Die H200-Fertigung wurde Medienberichten zufolge im März 2026 gestoppt und primär für China-Aufträge wieder angefahren (Pressestand, kein NVIDIA-Dokument) - der EU-Kanal läuft über Bestand und OEM-Allokation. Nelpx prüft Slots direkt beim Hersteller.
- Kernvorteil
- Läuft luftgekühlt im Bestands-Rechenzentrum (GIGABYTE G593: 5U, 10 bis 35 °C Betriebstemperatur) und fährt Modelle bis DeepSeek-R1 671B FP8 auf einem einzigen System.
- Gegenüber Blackwell
- Ausgereifter FP8-Stack, luftgekühlt in 5U, deutlich stärkere FP64-Leistung als der B300 (10 TFLOPS je System laut NVIDIA) - dafür kein FP4 und weniger Speicher.
Stand: 5. Oktober 2026 · Quellen: NVIDIA-Produktseite/Pressemitteilung und H200-Datenblatt, GIGABYTE-Produktseiten G593 und GIGAPOD, NVIDIA-Entwicklerblog, Presseberichte zur Fertigung - Herstellerclaims sind gekennzeichnet.
GIGABYTE G593: zwei CPU-Basen, Luft oder DLC
Anders als beim fest definierten DGX wählen Sie beim G593 die Host-Plattform passend zu Workload und Software-Stack - Intel oder AMD, Luft- oder Flüssigkühlung:
Bis 12-Kanal-DDR5 (24 DIMM-Slots), hohe Kernzahlen und ein starkes Preis-Leistungs-Profil - und aktuell deutlich kurzfristiger lieferbar als die Intel-Basis. Unsere Empfehlung.
32 DIMM-Slots (8-Kanal je CPU, DDR5 bis 5600 MT/s) und bis 4 TB RAM - der Speicher-Champion. Wichtig: Intel-Xeon-CPUs haben aktuell sehr lange Lieferzeiten (Stand August 2026).
Gleiche Plattform mit Kaltplatten auf CPU und GPU - laut GIGABYTE bis 64 GPUs (8 Server) je Rack, ausgelegt für 100 kW IT-Last. Für alle, die Dichte und Kühleffizienz maximieren wollen.
Quellen: GIGABYTE-Produktseiten G593-SD1-AAX3, G593-ZD1-AAX3 und G593-SD1-LAX3 sowie GIGABYTE-Pressemitteilungen. Betriebssysteme: u. a. Ubuntu LTS und RHEL mit CUDA-Stack - Freigabe je Konfiguration.
HGX H200 konfigurieren
Referenzwerte sind voreingestellt - jede Position anpassbar. Als PDF herunterladen oder direkt an uns senden.
= 8 GPUs · 1.128 GB HBM3e
Hinweis: Intel-Xeon-CPUs haben aktuell sehr lange Lieferzeiten (Stand August 2026) - wir empfehlen die AMD-EPYC-Basis. Konkrete Liefertermine prüfen wir im Angebot.
Hinweis: Mit BlueField-3 nennt GIGABYTE für den luftgekühlten G593-ZD1 max. 30 °C Umgebungstemperatur (ggf. angepasster PCIe-Einschub), für die DLC-Variante ZD1-LAX3 max. 25 °C - Details klären wir im Angebot.
Konfiguration und Kontaktdaten bleiben beim Ausfüllen vollständig in Ihrem Browser - Daten werden erst beim aktiven Absenden der E-Mail übertragen. Datenschutzerklärung
HGX H200 in Zahlen
Was passt in 1.128 GB GPU-Speicher, wo steht der H200 gegenüber H100 und Blackwell - und wo gewinnt er sogar gegen den B300:
Quellen: NVIDIA-Produktseiten (H200/HGX/NVLink), NVIDIA-Entwicklerblog (DeepSeek-R1, Llama 405B), MLPerf Inference v5.0 (Llama 2 70B Offline, 8× B200 gegen 8× H200, Einreicher NVIDIA), Modellgrößen via Hugging Face. NVIDIA gibt Tensor-Leistung standardmäßig mit Sparsity an - dense-Werte sind explizit ausgewiesen; FP64-Systemwerte je 8 GPUs teils rechnerisch (8× Einzel-GPU).
Alle technischen Daten anzeigen (Plattform + GIGABYTE G593)
| Spezifikation | NVIDIA HGX H200 im GIGABYTE G593 |
|---|---|
| GPUs | 8× NVIDIA H200 SXM (Hopper) · Tensor-Cores 4. Gen · bis 700 W je GPU (konfigurierbar) |
| GPU-Speicher | 1.128 GB HBM3e gesamt (141 GB je GPU) · 4,8 TB/s je GPU (rechnerisch 38,4 TB/s aggregiert) |
| Rechenleistung (System) | FP8: ~32 PFLOPS mit Sparsity / ~15,8 dense · FP16/BF16: ~15,8 / ~7,9 · TF32: ~7,9 / ~4 · FP64: 272 TFLOPS · FP64-Tensor-Core: 536 TFLOPS (rechnerisch 8× 34 bzw. 8× 67) |
| NVLink / NVSwitch | NVLink 4: 900 GB/s je GPU · 4× NVSwitch (3. Gen), jede GPU mit jeder voll vernetzt |
| MIG | Bis 7 Instanzen à 18 GB je GPU - bis 56 Partitionen pro System |
| Scale-out | Bis 8× 400G als Steckkarten (ConnectX-7 / BlueField-3) - InfiniBand NDR oder 400GbE, 1 NIC je GPU möglich |
| CPUs (wählbar) | 2× Intel Xeon Scalable 5./4. Gen (SD1, 32 DIMMs, bis 4 TB) oder 2× AMD EPYC 9005/9004 (ZD1, 24 DIMMs, bis 3 TB) |
| Storage | 8× 2,5" Gen5-NVMe hot-swap + M.2 (OS) |
| Erweiterung | 12× PCIe Gen5 x16 (4× FHHL + 8× LP) · 2× 10GbE Host-LAN onboard |
| Strom / Kühlung | 6× 3.000-W-Titanium-PSUs (redundant, 4+2 bzw. 5+1 je Variante) · Luftkühlung, 10 bis 35 °C Betriebstemperatur laut GIGABYTE · alternativ DLC (LAX3, CPU+GPU-Kaltplatten) |
| Formfaktor | 5U · 447 × 219,7 × 945 mm · ca. 88 bis 91 kg netto |
| Rack-Skalierung | DLC: bis 64 GPUs (8 Server) je Rack, ausgelegt für 100 kW IT-Last (GIGABYTE-Pressemitteilung zur G593-LAX3) · Luft: Stückzahl je Rack nach Strombudget - die Rackbelegung planen wir mit Ihnen |
| Software | Betriebssystem nach Kundenwunsch (Linux-Distributionen mit CUDA-Stack, Freigabe je Konfiguration laut GIGABYTE) · NVIDIA AI Enterprise als Add-on (bei SXM nicht enthalten) |
| Verfügbarkeit | Restverfügbarkeit aus Bestand und OEM-Allokation (Pressestand, kein NVIDIA-Dokument: Fertigung im März 2026 gestoppt, kurz darauf Neustart für China-Aufträge; eine Abkündigung haben wir nicht gefunden) - Slots über den GIGABYTE-Partnerkanal |
Vom Einzelserver zum Cluster
Der HGX H200 wächst mit: bis zu 8 400G-Ports pro System verbinden jede GPU mit dem Cluster - als InfiniBand- oder Ethernet-Fabric. Mehr dazu auf der Seite KI-Cluster kaufen.
Das Fabric liefern wir gleich mit: Als PNY-Partner beziehen wir das NVIDIA-Netzwerk über den offiziellen Distributionskanal - Switches, NICs und Kabel aus einer Hand, auf die ConnectX-7-Anbindung des HGX H200 abgestimmt. Preis auf Anfrage im Angebot.
Konfiguration, Allokationsprüfung und Lieferung laufen direkt über den Herstellerkanal - mit kurzen Wegen bei Kontingenten, Ersatzteilen und Eskalationen. Gerade bei Restverfügbarkeit zählt der direkte Draht. Und als PNY-Partner liefern wir das NVIDIA-Netzwerk gleich mit - Server und Fabric aus einer Hand.
Wofür lohnt sich der HGX H200 im Jahr 2026?
DeepSeek-R1 671B läuft in FP8 komplett auf einem System - von NVIDIA offiziell demonstriert. Llama 3.1 405B FP8 ist das Referenz-Deployment auf 8× H200. Kein Multi-Node-Sharding, keine Fabric-Komplexität.
CFD, FEM, Molekulardynamik: Mit rechnerisch 536 TFLOPS über den FP64-Tensor-Core-Pfad (reines FP64: 272 TFLOPS) pro System liegt der H200 weit vor dem B300 (10 TFLOPS je System laut NVIDIA) - Blackwell Ultra ist auf KI-Formate spezialisiert, Hopper bleibt die HPC-Wahl.
DSGVO-konforme LLM-Plattformen im eigenen Rechenzentrum: Prompts bleiben im eigenen Netz, die größten offenen Modelle passen komplett in die 1,1 TB GPU-Speicher.
Luftgekühlt in 5U statt Facility-Umbau: Der G593 ist bis 35 °C Betriebstemperatur spezifiziert und läuft in der vorhandenen Kaltgang-Einhausung - die luftgekühlten Blackwell-Server von GIGABYTE brauchen 8U und sind bis 30 °C spezifiziert.
8 GPUs mit je 141 GB lassen sich per MIG in bis zu 56 Instanzen à 18 GB partitionieren - eine Anschaffung, viele Teams, saubere Isolation.
Der am längsten gereifte Software-Stack (CUDA, vLLM, TensorRT-LLM) mit FP8 als kleinstem Format. Wer FP4 nicht braucht, bekommt mit Hopper eine erprobte Plattform - den Preis nennen wir im Angebot.
HGX H200, H200 NVL, HGX B200 oder B300?
Wann der HGX H200 passt - und wann ein anderes System die bessere Wahl ist.
Gründe für den HGX H200
- 1,1 TB reichen weit: DeepSeek-R1 671B und Llama 405B laufen in FP8 auf einem einzigen System - NVSwitch verbindet alle 8 GPUs mit je 900 GB/s.
- Bestands-RZ-tauglich: luftgekühlt in 5U, bis 35 °C Betriebstemperatur - kein Facility-Umbau, keine Flüssigkühlungs-Pflicht.
- FP64-HPC: rechnerisch 536 TFLOPS pro System über den Tensor-Core-Pfad (reines FP64: 272) - für Simulation und Wissenschaft klar vor Blackwell Ultra (B300: 10 TFLOPS je System).
- Ausgereifter Stack: FP8-Software seit Jahren im Einsatz, ohne Migrationsrisiko.
- Offene Plattform: CPU-Wahl (Intel/AMD), RAM bis 4 TB, freie OS-Wahl, Luft oder DLC - konfigurierbar statt Appliance.
Alternativen
- H200 NVL (PCIe): der flexible Einstieg für Bestandsserver - bis 4 Karten per NVLink-Bridge, inkl. 5 Jahren AI Enterprise (zur H200-NVL-Seite).
- HGX B200: gut doppelte FP8-Leistung und FP4-Support - der Schritt nach vorn, wenn Durchsatz vor Budget geht (zum B200-Konfigurator).
- HGX B300: 2,1 TB HBM3e und 800G-Netzwerk ab Werk - für Reasoning-Workloads und lange Kontexte (zur B300-Seite).
- Rack-Scale und nächste Generation: GB300 NVL72. NVIDIA meldete am 26.08.2026, dass die Vera-Rubin-Plattform in die volle Serienproduktion hochläuft und erste Racks bei Partnern laufen; Kundenprojekte mit Vera Rubin NVL72 planen wir ab H1 2027, das ist unsere Planung und keine Aussage von NVIDIA. Für GIGABYTE-Server mit HGX Rubin NVL8 ist kein Liefertermin veröffentlicht.
- AMD-Alternative: AMD Instinct MI355X und MI325X im GIGABYTE-Server, als Ausblick Instinct MI400.
- Einordnung: NVIDIA B300 und B200 als GPU erklärt und der Vergleich H100, H200, B200 und B300.
- Unsicher? Wir rechnen die Wege im Angebot transparent gegeneinander - inklusive Strom- und Kühlkosten (HGX und DGX im Vergleich).
Häufige Fragen zum NVIDIA HGX H200
Was kostet ein NVIDIA HGX H200 Server?
Der Preis ist konfigurationsabhängig und wird bei Nelpx auf Anfrage kalkuliert. Er hängt von CPU, RAM, Storage, Netzwerk und Stückzahl ab. NVIDIA und GIGABYTE veröffentlichen keine Listenpreise. Nelpx kalkuliert über den GIGABYTE-Partnerkanal und erstellt ein Angebot mit verbindlichem Preis und Liefertermin nach Allokationsprüfung - am schnellsten über den Konfigurator auf dieser Seite.
Ist der HGX H200 noch lieferbar und wie lange dauert die Lieferung?
Ja, aber aus Restverfügbarkeit: Medienberichten zufolge hat NVIDIA die H200-Chipfertigung im März 2026 zugunsten der nächsten Generation gestoppt und einen Neustart vor allem für freigegebene China-Aufträge angekündigt. Das ist der Pressestand, kein NVIDIA-Dokument; eine Abkündigung der H200 haben wir nicht gefunden. Für den europäischen Kanal zählen Bestand und laufende OEM-Allokation. Einzelsysteme sind über Integratoren typischerweise in wenigen Wochen lieferbar, größere Stückzahlen sind allokationsabhängig. Nelpx prüft konkrete Slots direkt im GIGABYTE-Partnerkanal - je früher die Anfrage, desto besser der Termin.
Wo kann man einen NVIDIA HGX H200 kaufen?
Nicht bei NVIDIA direkt: HGX ist eine Plattform, die Serverhersteller wie GIGABYTE in eigene Systeme integrieren - verkauft wird über deren Partner und Systemhäuser. Nelpx liefert HGX-H200-Systeme als offizieller GIGABYTE-Partner EU-weit, inklusive Konfiguration, Integration und Support - auf dieser Seite direkt konfigurierbar.
Lohnt sich der HGX H200 2026 noch - oder besser HGX B200/B300?
Der H200 bleibt 2026 die rationale Wahl, wenn FP8-Inferenz großer Modelle, Luftkühlung im Bestands-Rechenzentrum oder FP64-HPC im Vordergrund stehen: Der Software-Stack ist ausgereift, und bei FP64 liegt der H200 (pro System rechnerisch 272 TFLOPS, über den Tensor-Core-Pfad 536 TFLOPS) weit vor dem B300 (10 TFLOPS je System laut NVIDIA). Wer maximalen Token-Durchsatz mit FP4 oder größten GPU-Speicher braucht, greift zum HGX B200 oder B300 - Nelpx rechnet beide Wege im Angebot gegen.
Was ist der Unterschied zwischen HGX H200 und DGX H200?
Beide nutzen dasselbe 8-GPU-Baseboard mit identischer GPU-Leistung. Der DGX H200 ist NVIDIAs fest definiertes Komplettsystem (2× Xeon Platinum 8480C, 2 TB RAM, DGX OS, NVIDIA-Software inklusive). Ein HGX-H200-Server wie der GIGABYTE G593 ist die offene Variante: CPU wählbar (Intel Xeon oder AMD EPYC), RAM bis 4 TB, Storage und Netzwerk frei konfigurierbar. Nelpx liefert die HGX-Variante von GIGABYTE, das DGX-System bieten wir nicht an.
Was ist der Unterschied zwischen H200 SXM (HGX) und H200 NVL (PCIe)?
Speicher und Bandbreite sind identisch (141 GB HBM3e, 4,8 TB/s je GPU). Die SXM-Version im HGX-System leistet mehr (FP8 3.958 statt 3.341 TFLOPS mit Sparsity, bis 700 statt 600 W) und verbindet alle 8 GPUs über NVSwitch mit je 900 GB/s - beim NVL-PCIe-Format sind maximal 4 Karten per NVLink-Bridge koppelbar. Die NVL-Karte ist dafür der flexible Einstieg für Bestandsserver (zur H200-NVL-Seite). Wichtiger Unterschied bei der Software: Bei der NVL-Karte ist eine 5-Jahres-Subscription von NVIDIA AI Enterprise enthalten, bei SXM-Systemen nicht.
Welche KI-Modelle laufen auf einem HGX H200 mit 1,1 TB HBM3e?
Die 1.128 GB GPU-Speicher reichen für die größten offenen Modelle in FP8: DeepSeek-R1 671B (~685 GB Gewichte) läuft komplett auf einem einzigen System - von NVIDIA offiziell mit bis zu 3.872 Token/s demonstriert. Llama 3.1 405B FP8 (~406 GB) ist NVIDIAs Referenz-Deployment auf 8× H200, Qwen3-235B und Mistral Large passen komfortabel, und Llama 3.3 70B läuft bereits auf einer einzelnen der acht GPUs.
Wie viel schneller ist der H200 als der H100?
NVIDIA nennt für Llama 2 70B bis zu 1,9-fache Inferenzleistung der H200 gegenüber der H100 (Herstellerangabe aus dem H200-Datenblatt, je eine GPU, H200 mit größerer Batch). In MLPerf Inference v5.0 erreichte ein System mit 8× H200 34.988 Token/s (Llama 2 70B Offline, Einreicher NVIDIA). Der Vorsprung kommt vor allem aus dem Speicher: 141 statt 80 GB pro GPU und 4,8 statt 3,35 TB/s Bandbreite. Die Rechenwerte beider GPUs sind laut Datenblatt gleich. Die H100 ist laut Mitteilungen aus Distribution und von Serverherstellern abgekündigt (Stand der Restbestände: NVIDIA H100 kaufen), der H200 ist die verbleibende Hopper-Option.
Wie viel Strom verbraucht ein HGX-H200-Server und welche Kühlung braucht er?
GIGABYTE veröffentlicht für den G593 keinen Verbrauchswert, nur die Netzteile: 6× 3.000 W Titanium, redundant. Die 8 GPUs sind laut NVIDIA mit bis zu 8× 700 W konfigurierbar. Der GIGABYTE G593 ist als luftgekühlter 5U-Server für 10 bis 35 °C Betriebstemperatur spezifiziert und läuft in klassischen Kaltgang-Umgebungen. Für höhere Rack-Dichte gibt es die DLC-Variante (G593-LAX3) mit Kaltplatten auf CPU und GPU - laut GIGABYTE bis 64 GPUs (8 Server) je Rack, ausgelegt für 100 kW IT-Last.
Welche CPUs und wie viel RAM gehören in einen HGX-H200-Server?
Beim GIGABYTE G593 sind zwei Basen wählbar: G593-SD1 mit 2× Intel Xeon Scalable der 4./5. Generation (32 DIMM-Slots, bis 4 TB DDR5) oder G593-ZD1 mit 2× AMD EPYC 9005/9004 (24 DIMM-Slots, bis 3 TB). Bewährter Sweet Spot sind 2 TB RAM - das entspricht der Auslegung von NVIDIAs DGX-Referenz; als CPU-Empfehlung gelten 32 Kerne oder mehr pro Sockel für Daten-Preprocessing neben den GPUs. Wichtig für die Terminplanung: Intel-Xeon-CPUs haben aktuell sehr lange Lieferzeiten (Stand August 2026) - Nelpx empfiehlt daher die kurzfristiger lieferbare AMD-EPYC-Basis G593-ZD1.
Ist NVIDIA AI Enterprise beim HGX H200 enthalten?
Nein - bei H200-SXM-Systemen führt NVIDIA die AI-Enterprise-Suite als kostenpflichtiges Add-on (anders als bei der H200-NVL-PCIe-Karte, wo eine 5-Jahres-Subscription enthalten ist). Der Server läuft alternativ vollständig ohne AI-Enterprise-Lizenz: eine gängige Linux-Distribution mit dem frei verfügbaren CUDA-Stack, dazu Open-Source-Serving wie vLLM, SGLang oder Triton. Nelpx weist Lizenzkosten im Angebot transparent aus, wenn AI Enterprise gewünscht ist.
Ist ein HGX-H200-Server DSGVO-konform betreibbar?
Ja - als On-Premise-System bleiben Trainingsdaten, Prompts und Modelle vollständig in der eigenen Infrastruktur, was DSGVO-Bewertung und EU-AI-Act-Einordnung deutlich vereinfacht. Mit 1,1 TB GPU-Speicher laufen auch die größten offenen Modelle lokal; Nelpx konzipiert die Umgebung inklusive Netzwerk- und Sicherheitsarchitektur.