GPU-Server konfigurieren.
Vom 1HE-System bis zur HGX-Plattform.
13 Basissysteme auf GIGABYTE-Basis: PCIe-GPU-Server von 1HE bis 4HE mit bis zu 8 Karten, dazu NVIDIA HGX H200, B200 und B300 mit 8 SXM-GPUs. Prozessor, ECC-RAM, GPUs, Storage und Netzwerk wählen Sie online - die Empfehlungs-Engine markiert je Einsatzzweck die passende Option. HGX B200 ab 370.000 € netto, HGX B300 ab 450.000 € netto, alle anderen Systeme projektbezogen kalkuliert.
Sie brauchen eine Workstation statt eines Rack-Servers? KI-Workstation konfigurieren
GPU-Server konfigurieren:
So geht's.
Ob 1HE-Inferenz-Server, 4HE-System mit acht GPUs oder HGX-Plattform - der Weg zum Angebot ist derselbe. Ohne Registrierung, ohne versteckte Schritte.
Bei Nelpx konfigurieren Sie GPU-Server in drei Schritten online: Basissystem wählen, Einsatzzweck festlegen, Hardware anpassen. Die Konfiguration geht als PDF oder E-Mail an sales@nelpx.de - das Angebot kommt von Nelpx.
- Basissystem wählen
13 GPU-Server von 1HE bis 4HE (AMD EPYC, Intel Xeon 6, bis 8 PCIe-GPUs) und NVIDIA HGX H200, B200 und B300 mit 8 SXM-GPUs.
- Einsatzzweck & Hardware
Einsatzzweck wählen (Inferenz, Training oder Mixed/HPC) - Prozessor, ECC-RAM, GPUs, Enterprise-NVMe und Netzwerk werden passend vorbelegt, inklusive Begründung und Warnung bei Abweichungen.
- PDF laden & Angebot erhalten
Konfiguration als PDF herunterladen oder per Mail-Button an sales@nelpx.de senden - Nelpx kalkuliert das Angebot projektbezogen.
Stand: September 2026 · HGX B200 ab 370.000 € netto, HGX B300 ab 450.000 € netto - alle anderen Systeme werden projektbezogen kalkuliert.
GPU-Server im Überblick:
1HE bis HGX mit 8 GPUs.
Drei Klassen, ein Konfigurator. Klicken Sie ein System an - es wird im Konfigurator vorausgewählt, alle Optionen passen sich der Plattform an.
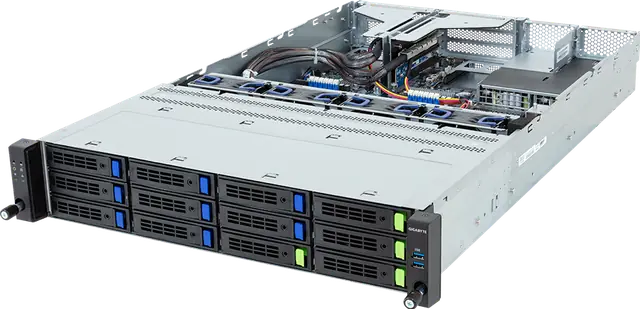
Inferenz und GPU-Dienste - 1 bis 4 Karten
Single- oder Dual-AMD-EPYC (9004/9005, bis 192 Kerne), bis 2,3 TB RDIMM-ECC, Gen5-NVMe-Hot-Swap, redundante Titanium-Netzteile. GPUs: NVIDIA RTX PRO 4500 Server Edition, L40S oder RTX PRO 6000 Server Edition.
Preis projektbezogen - Konfiguration senden, Angebot von Nelpx erhalten. Plattform-Details: AMD EPYC 9005 Server · Welche GPU passt in welches Barebone?
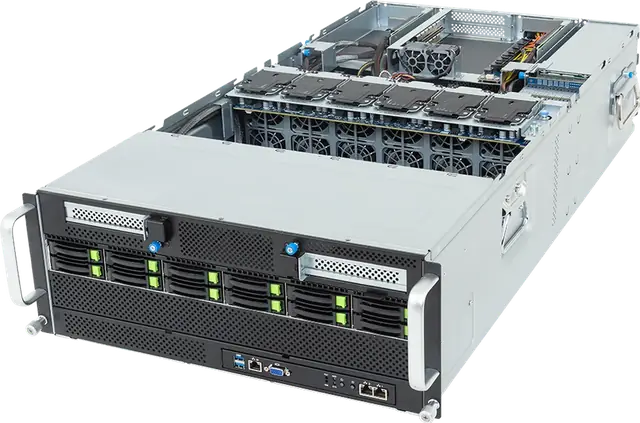
Schwere PCIe-Beschleuniger - bis 8 Karten
Für Dual-Slot-Karten wie NVIDIA H200 NVL (141 GB HBM3e) und RTX PRO 6000 Server Edition (96 GB): PCIe-Gen5-x16 in voller Breite, bis 4,6 TB ECC-RAM und 4× 3.000-W-Titanium-Netzteile im 4HE-Flaggschiff. AMD EPYC oder Intel Xeon 6 mit bis zu 128 Kernen.
Feste Preise aus unserem Sortiment: GIGABYTE XL44 mit 8× RTX PRO 6000 Server Edition ab 149.000 € netto · NVIDIA H200 NVL ab 26.500 € netto je Karte
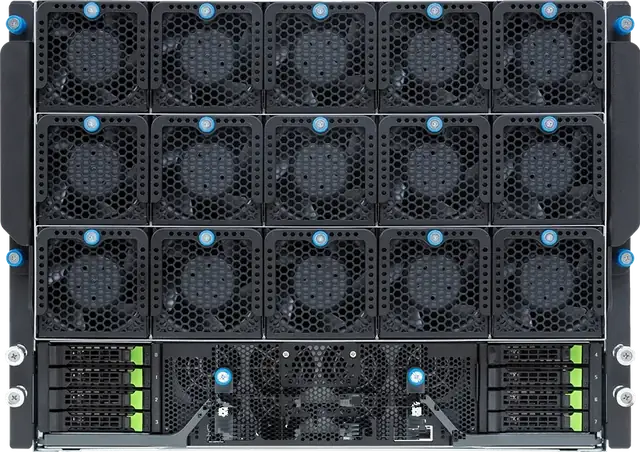
Training und Inferenz im Maßstab - 8 NVLink-GPUs
Acht NVLink-verbundene SXM-GPUs mit 1,1 bis 2,1 TB HBM3e, Dual-EPYC oder Dual-Xeon, bis 4 TB RDIMM-ECC, 8× Gen5-Hot-Swap. HGX B300 mit acht ConnectX-8-Ports onboard (bis 800 Gb/s je GPU), luft- oder flüssiggekühlt als GIGABYTE G593, G893 und G894.
HGX B200 ab 370.000 € netto · HGX B300 ab 450.000 € netto · HGX H200 Preis auf Anfrage - jeweils Basiskonfiguration, Projektpreis nach Allokation und Ausstattung.
Ihr System.
Ihre Konfiguration.
Wählen Sie Basissystem und Einsatzzweck - danach markiert der Konfigurator in jeder Sektion die passende Option als „Empfohlen", nennt den technischen Grund und warnt bei kritischen Abweichungen. Anpassen können Sie alles.
Workstation statt Rack-Server? KI-Workstation konfigurieren - eigener Konfigurator mit RTX 5090 und RTX PRO Blackwell.
Datenschutz: Ihre Eingaben bleiben vollständig in Ihrem Browser - Daten werden erst beim aktiven Absenden der E-Mail übertragen. Datenschutzerklärung
GPU-Server oder
GPU-Workstation?
Die wichtigste Frage vor der Konfiguration. Die Kurzform: Dienste für mehrere Nutzer gehören auf den Server im Rack - das persönliche Entwicklungssystem auf den Schreibtisch. Workstations konfigurieren Sie auf der Seite KI-Workstation konfigurieren. Weiterführend: LLM-Server kaufen, KI-Server für Unternehmen, GPU-Cluster kaufen und Server-Colocation in Deutschland. Noch unsicher, welche Systemklasse passt? Der KI-Lösungsfinder führt in vier Schritten zur Empfehlung.
| Kriterium | GPU ServerRack · 1HE-5HE · bis 8 GPUs | GPU WorkstationTower / Mini-PC · 1-4 GPUs |
|---|---|---|
| Einsatzort | Rechenzentrum oder Serverraum (19"-Rack) | Büro und Arbeitsplatz - leise Luftkühlung |
| Typische Workloads | KI-Inferenz-Dienste, Multi-User-Umgebungen, Training, HPC-Simulation im Dauerbetrieb | KI-Entwicklung, Finetuning, lokales Training, Datenanalyse, Simulation am Arbeitsplatz |
| GPUs | Bis 8× PCIe (RTX PRO, L40S, H200 NVL) oder 8× SXM (HGX H200/B200/B300) | 1× (RTX 5090, RTX PRO 5000/6000 Blackwell) oder bis 4× RTX PRO 6000 Max-Q - bis 384 GB VRAM |
| Prozessoren | AMD EPYC (bis 192 Kerne), Intel Xeon 6 (bis 128 Kerne), Single/Dual-Socket | Ryzen 9, Core Ultra, Threadripper PRO (bis 96 Kerne) |
| Arbeitsspeicher | RDIMM ECC DDR5 - bis 4.608 GB | DDR5 bis 192 GB, Threadripper PRO mit ECC bis 512 GB |
| Betrieb | 24/7-Dauerbetrieb, redundante Titanium-Netzteile, Management-LAN für Fernwartung | Arbeitsplatzbetrieb, auf tagelange Volllast ausgelegte Kühlung |
| Skalierung | Cluster-fähig - InfiniBand / Spectrum-X Ethernet bis 800 Gb/s pro GPU | Einzelsystem; AI Mini (GB10) im Duo koppelbar |
Unsicher? Wählen Sie im Konfigurator Ihren Einsatzzweck - die Empfehlungen je Sektion passen sich sofort an, Besonderheiten notieren Sie im Anmerkungsfeld.
Vom Inferenz-Server bis zum
HPC-System.
Vier typische Anforderungsprofile - und welche GPU-Server wir dafür konfigurieren. Jede Empfehlung führt direkt in den Konfigurator oder zur passenden Produktseite.
LLM-Inferenz & KI-Dienste
Sprachmodelle, RAG-Systeme und KI-APIs für viele parallele Nutzer: Hier zählen GPU-Speicher und Durchsatz pro Höheneinheit - im 24/7-Betrieb mit redundanter Stromversorgung.
KI-Entwicklung & Finetuning
Modelle anpassen, LoRA-Training, Prototyping mit PyTorch und TensorFlow - im Rack als geteilter Entwicklungsserver mit ein bis vier GPUs oder als persönliche Workstation am Arbeitsplatz.
Modell-Training
Eigene Modelle von Grund auf oder große Finetunings: Multi-GPU-Systeme mit PCIe- oder NVLink-Verbund - vom 4HE-Server mit 8× RTX PRO 6000 bis 8× SXM im HGX-Server.
HPC & Simulation
CFD, FEM, Molekulardynamik und Rendering brauchen Kerne, ECC-Speicher und I/O statt maximaler GPU-Dichte: AMD EPYC bis 192 Kerne und 4.608 GB RAM im Server.
Konfigurieren ist einfach.
Richtig bauen ist unser Job.
Jede Konfiguration prüfen wir auf Kompatibilität, Kühlung und Stromversorgung - und optimieren sie auf Ihren Workload, bevor sie in die Fertigung geht.
Wir bauen auf Basis von GIGABYTE-Plattformen - als offizieller Partner wählen wir das Chassis, das zu Ihrer GPU-Bestückung, Kühlung und Ihrem Rechenzentrum passt.
Jedes System durchläuft vor der Auslieferung intensive Last- und Qualitätstests - GPUs, Speicher und Storage inklusive. Was bei Ihnen ankommt, ist bewiesen stabil.
Ob einzelner GPU-Server oder HGX-Cluster mit InfiniBand-Fabric: Wir beraten bis auf Netzwerk- und Software-Ebene - aus Deutschland, mit Lieferung EU-weit.
GPU-Server konfigurieren:
Kurz beantwortet.
Die Fragen, die uns vor der Konfiguration von GPU-Servern, KI-Servern und HPC-Systemen am häufigsten erreichen.
Wie kann ich einen GPU-Server konfigurieren?
Was ist ein GPU-Server?
Welche GPU brauche ich für LLM-Inferenz und Training?
GPU-Server oder GPU-Workstation - was ist das richtige System?
Was unterscheidet einen KI-Server von einem HPC-Server?
Was kostet ein GPU-Server?
Lassen sich die Systeme später zum Cluster erweitern?
Wie schnell erhalte ich Angebot und Lieferung?
Ihre Konfiguration.
Unser Angebot.
Senden Sie uns Ihre Konfiguration aus dem Konfigurator. Sie erhalten ein Angebot, geliefert wird EU-weit.
GPU-Server konfigurieren.
Vom 1HE-System bis zur HGX-Plattform.
13 Basissysteme auf GIGABYTE-Basis: PCIe-GPU-Server von 1HE bis 4HE mit bis zu 8 Karten, dazu NVIDIA HGX H200, B200 und B300 mit 8 SXM-GPUs. Prozessor, ECC-RAM, GPUs, Storage und Netzwerk wählen Sie online - die Empfehlungs-Engine markiert je Einsatzzweck die passende Option. HGX B200 ab 370.000 € netto, HGX B300 ab 450.000 € netto, alle anderen Systeme projektbezogen kalkuliert.
Sie brauchen eine Workstation statt eines Rack-Servers? KI-Workstation konfigurieren
GPU-Server konfigurieren:
So geht's.
Ob 1HE-Inferenz-Server, 4HE-System mit acht GPUs oder HGX-Plattform - der Weg zum Angebot ist derselbe. Ohne Registrierung, ohne versteckte Schritte.
Bei Nelpx konfigurieren Sie GPU-Server in drei Schritten online: Basissystem wählen, Einsatzzweck festlegen, Hardware anpassen. Die Konfiguration geht als PDF oder E-Mail an sales@nelpx.de - das Angebot kommt von Nelpx.
- Basissystem wählen
13 GPU-Server von 1HE bis 4HE (AMD EPYC, Intel Xeon 6, bis 8 PCIe-GPUs) und NVIDIA HGX H200, B200 und B300 mit 8 SXM-GPUs.
- Einsatzzweck & Hardware
Einsatzzweck wählen (Inferenz, Training oder Mixed/HPC) - Prozessor, ECC-RAM, GPUs, Enterprise-NVMe und Netzwerk werden passend vorbelegt, inklusive Begründung und Warnung bei Abweichungen.
- PDF laden & Angebot erhalten
Konfiguration als PDF herunterladen oder per Mail-Button an sales@nelpx.de senden - Nelpx kalkuliert das Angebot projektbezogen.
Stand: September 2026 · HGX B200 ab 370.000 € netto, HGX B300 ab 450.000 € netto - alle anderen Systeme werden projektbezogen kalkuliert.
GPU-Server im Überblick:
1HE bis HGX mit 8 GPUs.
Drei Klassen, ein Konfigurator. Klicken Sie ein System an - es wird im Konfigurator vorausgewählt, alle Optionen passen sich der Plattform an.
Inferenz und GPU-Dienste - 1 bis 4 Karten
Single- oder Dual-AMD-EPYC (9004/9005, bis 192 Kerne), bis 2,3 TB RDIMM-ECC, Gen5-NVMe-Hot-Swap, redundante Titanium-Netzteile. GPUs: NVIDIA RTX PRO 4500 Server Edition, L40S oder RTX PRO 6000 Server Edition.
Preis projektbezogen - Konfiguration senden, Angebot von Nelpx erhalten. Plattform-Details: AMD EPYC 9005 Server · Welche GPU passt in welches Barebone?
Schwere PCIe-Beschleuniger - bis 8 Karten
Für Dual-Slot-Karten wie NVIDIA H200 NVL (141 GB HBM3e) und RTX PRO 6000 Server Edition (96 GB): PCIe-Gen5-x16 in voller Breite, bis 4,6 TB ECC-RAM und 4× 3.000-W-Titanium-Netzteile im 4HE-Flaggschiff. AMD EPYC oder Intel Xeon 6 mit bis zu 128 Kernen.
Feste Preise aus unserem Sortiment: GIGABYTE XL44 mit 8× RTX PRO 6000 Server Edition ab 149.000 € netto · NVIDIA H200 NVL ab 26.500 € netto je Karte
Training und Inferenz im Maßstab - 8 NVLink-GPUs
Acht NVLink-verbundene SXM-GPUs mit 1,1 bis 2,1 TB HBM3e, Dual-EPYC oder Dual-Xeon, bis 4 TB RDIMM-ECC, 8× Gen5-Hot-Swap. HGX B300 mit acht ConnectX-8-Ports onboard (bis 800 Gb/s je GPU), luft- oder flüssiggekühlt als GIGABYTE G593, G893 und G894.
HGX B200 ab 370.000 € netto · HGX B300 ab 450.000 € netto · HGX H200 Preis auf Anfrage - jeweils Basiskonfiguration, Projektpreis nach Allokation und Ausstattung.
Ihr System.
Ihre Konfiguration.
Wählen Sie Basissystem und Einsatzzweck - danach markiert der Konfigurator in jeder Sektion die passende Option als „Empfohlen", nennt den technischen Grund und warnt bei kritischen Abweichungen. Anpassen können Sie alles.
Workstation statt Rack-Server? KI-Workstation konfigurieren - eigener Konfigurator mit RTX 5090 und RTX PRO Blackwell.
Datenschutz: Ihre Eingaben bleiben vollständig in Ihrem Browser - Daten werden erst beim aktiven Absenden der E-Mail übertragen. Datenschutzerklärung
GPU-Server oder
GPU-Workstation?
Die wichtigste Frage vor der Konfiguration. Die Kurzform: Dienste für mehrere Nutzer gehören auf den Server im Rack - das persönliche Entwicklungssystem auf den Schreibtisch. Workstations konfigurieren Sie auf der Seite KI-Workstation konfigurieren. Weiterführend: LLM-Server kaufen, KI-Server für Unternehmen, GPU-Cluster kaufen und Server-Colocation in Deutschland. Noch unsicher, welche Systemklasse passt? Der KI-Lösungsfinder führt in vier Schritten zur Empfehlung.
| Kriterium | GPU ServerRack · 1HE-5HE · bis 8 GPUs | GPU WorkstationTower / Mini-PC · 1-4 GPUs |
|---|---|---|
| Einsatzort | Rechenzentrum oder Serverraum (19"-Rack) | Büro und Arbeitsplatz - leise Luftkühlung |
| Typische Workloads | KI-Inferenz-Dienste, Multi-User-Umgebungen, Training, HPC-Simulation im Dauerbetrieb | KI-Entwicklung, Finetuning, lokales Training, Datenanalyse, Simulation am Arbeitsplatz |
| GPUs | Bis 8× PCIe (RTX PRO, L40S, H200 NVL) oder 8× SXM (HGX H200/B200/B300) | 1× (RTX 5090, RTX PRO 5000/6000 Blackwell) oder bis 4× RTX PRO 6000 Max-Q - bis 384 GB VRAM |
| Prozessoren | AMD EPYC (bis 192 Kerne), Intel Xeon 6 (bis 128 Kerne), Single/Dual-Socket | Ryzen 9, Core Ultra, Threadripper PRO (bis 96 Kerne) |
| Arbeitsspeicher | RDIMM ECC DDR5 - bis 4.608 GB | DDR5 bis 192 GB, Threadripper PRO mit ECC bis 512 GB |
| Betrieb | 24/7-Dauerbetrieb, redundante Titanium-Netzteile, Management-LAN für Fernwartung | Arbeitsplatzbetrieb, auf tagelange Volllast ausgelegte Kühlung |
| Skalierung | Cluster-fähig - InfiniBand / Spectrum-X Ethernet bis 800 Gb/s pro GPU | Einzelsystem; AI Mini (GB10) im Duo koppelbar |
Unsicher? Wählen Sie im Konfigurator Ihren Einsatzzweck - die Empfehlungen je Sektion passen sich sofort an, Besonderheiten notieren Sie im Anmerkungsfeld.
Vom Inferenz-Server bis zum
HPC-System.
Vier typische Anforderungsprofile - und welche GPU-Server wir dafür konfigurieren. Jede Empfehlung führt direkt in den Konfigurator oder zur passenden Produktseite.
LLM-Inferenz & KI-Dienste
Sprachmodelle, RAG-Systeme und KI-APIs für viele parallele Nutzer: Hier zählen GPU-Speicher und Durchsatz pro Höheneinheit - im 24/7-Betrieb mit redundanter Stromversorgung.
KI-Entwicklung & Finetuning
Modelle anpassen, LoRA-Training, Prototyping mit PyTorch und TensorFlow - im Rack als geteilter Entwicklungsserver mit ein bis vier GPUs oder als persönliche Workstation am Arbeitsplatz.
Modell-Training
Eigene Modelle von Grund auf oder große Finetunings: Multi-GPU-Systeme mit PCIe- oder NVLink-Verbund - vom 4HE-Server mit 8× RTX PRO 6000 bis 8× SXM im HGX-Server.
HPC & Simulation
CFD, FEM, Molekulardynamik und Rendering brauchen Kerne, ECC-Speicher und I/O statt maximaler GPU-Dichte: AMD EPYC bis 192 Kerne und 4.608 GB RAM im Server.
Konfigurieren ist einfach.
Richtig bauen ist unser Job.
Jede Konfiguration prüfen wir auf Kompatibilität, Kühlung und Stromversorgung - und optimieren sie auf Ihren Workload, bevor sie in die Fertigung geht.
Wir bauen auf Basis von GIGABYTE-Plattformen - als offizieller Partner wählen wir das Chassis, das zu Ihrer GPU-Bestückung, Kühlung und Ihrem Rechenzentrum passt.
Jedes System durchläuft vor der Auslieferung intensive Last- und Qualitätstests - GPUs, Speicher und Storage inklusive. Was bei Ihnen ankommt, ist bewiesen stabil.
Ob einzelner GPU-Server oder HGX-Cluster mit InfiniBand-Fabric: Wir beraten bis auf Netzwerk- und Software-Ebene - aus Deutschland, mit Lieferung EU-weit.
GPU-Server konfigurieren:
Kurz beantwortet.
Die Fragen, die uns vor der Konfiguration von GPU-Servern, KI-Servern und HPC-Systemen am häufigsten erreichen.
Wie kann ich einen GPU-Server konfigurieren?
Was ist ein GPU-Server?
Welche GPU brauche ich für LLM-Inferenz und Training?
GPU-Server oder GPU-Workstation - was ist das richtige System?
Was unterscheidet einen KI-Server von einem HPC-Server?
Was kostet ein GPU-Server?
Lassen sich die Systeme später zum Cluster erweitern?
Wie schnell erhalte ich Angebot und Lieferung?
Ihre Konfiguration.
Unser Angebot.
Senden Sie uns Ihre Konfiguration aus dem Konfigurator. Sie erhalten ein Angebot, geliefert wird EU-weit.