Mac Studio Cluster mit M5 Ultra: zwei bis vier Geräte für große Sprachmodelle
Mehrere Mac Studio mit M5 Ultra lassen sich direkt über Thunderbolt 5 mit RDMA verbinden. Das Modell wird auf die Geräte verteilt: Vier Geräte mit je 512 GB bringen 2 TB Arbeitsspeicher zusammen, und laut Apple-Messung erzeugen vier Geräte rund dreimal so viele Token pro Sekunde wie eines.
IT-Systemhaus für HPC & AI-Infrastruktur · Lieferung EU-weit · Konfiguration, Angebot und Lieferung aus einer Hand
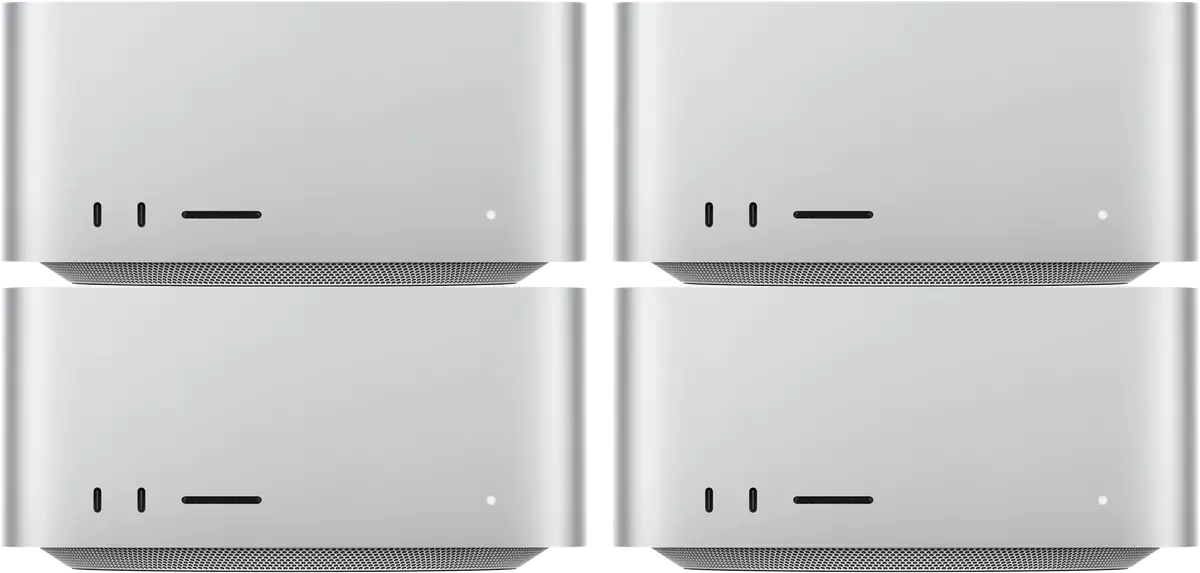
Was ist ein Mac Studio Cluster?
Ein Mac Studio Cluster besteht aus zwei bis vier Mac Studio mit M5 Ultra, die direkt über Thunderbolt-5-Kabel verbunden sind. Seit macOS 26.2 tauschen die Geräte Daten per RDMA mit geringer Latenz aus. Software wie MLX oder exo verteilt ein Sprachmodell auf alle Geräte, sodass sich der Arbeitsspeicher addiert, mit vier Geräten zu je 512 GB auf 2 TB. Laut Apple erzeugen vier Geräte bei einem 128-Milliarden-Modell 3,04-mal so viele Token pro Sekunde wie eines. Nelpx liefert die Geräte EU-weit.
- Verbindung
- Thunderbolt 5 + RDMAdirekt, ohne Switch, ab macOS 26.2
- Speicher
- bis 2 TB4 × 512 GB, 1,2 TB/s je Gerät
- Tempo
- 2,6 bis 3,0×4 statt 1 Gerät bei 8.192 Token Kontext, Apple, veröffentlicht 15.10.2026
Quellen: Apple TN3205 „Low-latency communication with RDMA over Thunderbolt“, Apple Technische Daten Mac Studio (2026), Apple Machine Learning Research „Local and Distributed Large LLM Inference with MLX and RDMA on Mac Studio“ vom 15.10.2026. Abgerufen am 20.10.2026.
Wie werden die Mac Studio verkabelt?
Jedes Gerät wird mit jedem anderen direkt über ein Thunderbolt-5-Kabel verbunden. Dieser Aufbau heißt Full Mesh und ist der, den Apple misst. Switches für Thunderbolt 5 gibt es nach heutigem Stand nicht, und RDMA über Thunderbolt verbindet laut Apple immer nur zwei Macs direkt.
- 1 Thunderbolt-5-Kabel zwischen den beiden Geräten, je Gerät ist 1 Anschluss belegt.
- Mit 2 Kabeln verdoppelt sich die Bandbreite der Verbindung. MLX nutzt beide Kabel gleichzeitig.
- Speicher: 192, 512 oder 1.024 GB, je nach Ausbau mit 96, 256 oder 512 GB.
- Steuernetz: Beide Geräte brauchen zusätzlich eine Verbindung über Ethernet oder WLAN für SSH.
- 3 Thunderbolt-5-Kabel, jedes Gerät ist mit den beiden anderen verbunden, je Gerät sind 2 Anschlüsse belegt.
- Mit 2 Kabeln je Verbindung sind es 6 Kabel und 4 belegte Anschlüsse je Gerät.
- Speicher: 288, 768 oder 1.536 GB.
- Unsere Empfehlung: 2 oder 4 Geräte. Apple hat Messwerte nur für 2 und 4 Geräte veröffentlicht, und bei den meisten Modellen lassen sich die Matrixgrößen, etwa die Zwischendimension, nicht durch 3 teilen. Dann bieten exo und MLX für 3 Geräte nur die schichtweise Verteilung an, die nicht schneller ist.
- 6 Thunderbolt-5-Kabel, jedes Gerät ist mit den drei anderen verbunden, je Gerät sind 3 Anschlüsse belegt. So vermascht nennt Apple „bis zu 3× schneller“; die Messwerte vom Oktober 2026 entstanden mit 2 Kabeln je Verbindung.
- Mit 2 Kabeln je Verbindung sind es 12 Kabel, dann sind alle 6 Anschlüsse jedes Geräts belegt. In Apples Messung mit Muse Spark Open 816B sank die Wartezeit auf das erste Token bei einem 65.536-Token-Kontext dadurch von 50,5 auf 40,6 s.
- Speicher: 384, 1.024 oder 2.048 GB.
- Strom: Apple hat bei der Inferenz rund 300 W Spitze je M5 Ultra gemessen, für vier Geräte ergibt das nach unserer Hochrechnung rund 1.200 W. Ausgelegt ist jedes Gerät auf höchstens 480 W Dauerleistung.
Kabel: Apple nennt für RDMA keine Kabelempfehlung. Bewährt sind passive Thunderbolt-5-Kabel mit 1 m, zum Beispiel das Thunderbolt 5 (USB-C) Pro Kabel von Apple mit 80 Gbit/s in beide Richtungen und bis 120 Gbit/s in eine Richtung. Für längere Wege gibt es aktive Kabel. Grundlage: Apple TN3205, MLX-Dokumentation „Distributed Communication“, Apple Machine Learning Research (15.10.2026), Jeff Geerling (18.12.2025), Macworld (23.01.2026).
Mac Studio Cluster zusammenstellen und anfragen
Wählen Sie Anzahl und Ausstattung. Die Tempo-Angaben stammen aus Apples Messung mit 2 Kabeln je Verbindung. Rechts sehen Sie den Nettopreis je Gerät und für den Cluster, die Lieferzeit und welche Modelle hineinpassen. Alle Geräte eines Clusters sollten gleich ausgestattet sein.
Anzahl Mac Studio
Chip
Arbeitsspeicher je Gerät
SSD je Gerät
Beim verteilten Rechnen braucht jedes Gerät das komplette Modell auf der eigenen SSD und lädt davon seinen Anteil in den Arbeitsspeicher.
Thunderbolt-5-Kabel
Die Anzahl gilt für den ganzen Cluster: jedes Gerät mit jedem anderen direkt verbunden.
Angebot anfordern
Optional - die Angaben wandern in die E-Mail und ins PDF. Sie erhalten ein Angebot mit Nettopreis, Kabeln und Liefertermin.
Ihre Eingaben bleiben beim Ausfüllen vollständig in Ihrem Browser - übertragen wird erst beim aktiven Absenden der E-Mail. Datenschutzerklärung
Welches Modell braucht wie viele Mac Studio?
Die Tabelle rechnet mit der echten Dateigröße der MLX-Fassung auf Hugging Face plus 15 % Reserve für Kontext und Laufzeit. Als nutzbar rechnen wir mit rund drei Vierteln des Arbeitsspeichers, ein Erfahrungswert für das Standardlimit von macOS, das Apple nicht dokumentiert.
| Modell (MLX) | Dateigröße | 1 × 512 GB | 2 × 256 GB | 2 × 512 GB oder 4 × 256 GB | 4 × 512 GB |
|---|---|---|---|---|---|
| Qwen3.5 397B-A17B 4-Bit | 224 GB | passt | passt | passt | passt |
| MiniMax M3 4-Bit | 242 GB | passt | passt | passt | passt |
| DeepSeek V3.2 4-Bit | 378 GB | knapp* | knapp* | passt | passt |
| GLM-5.3 4-Bit | 418 GB | knapp* | knapp* | passt | passt |
| Qwen3.5 397B-A17B 8-Bit | 422 GB | knapp* | knapp* | passt | passt |
| Kimi K2.5 (INT4) | 658 GB | nein | nein | passt | passt |
| DeepSeek V3.2 8-Bit | 756 GB | nein | nein | knapp* | passt |
| DeepSeek V4 Pro 4-Bit | 837 GB | nein | nein | knapp* | passt |
* knapp = passt nur, wenn das GPU-Speicherlimit von macOS angehoben wird (Schlüssel iogpu.wired_limit_mb, von Apple nicht dokumentiert). Beim verteilten Rechnen (Tensor-Parallelismus) braucht jedes Gerät zusätzlich das ganze Modell auf der SSD, ab rund 600 GB empfehlen wir 2 TB. Dateigrößen: Summe der safetensors-Dateien der Repositories von mlx-community auf Hugging Face, GB = 10^9 Byte, abgerufen am 20.10.2026. Richtwert, kein Leistungsversprechen; sehr lange Kontexte brauchen mehr Reserve.
Wie viel schneller ist ein Cluster?
Bei verteiltem Rechnen (Tensor-Parallelismus) arbeiten alle Geräte gleichzeitig an jedem Token. Apple hat dazu am 15.10.2026 Messwerte mit M5 Ultra veröffentlicht: Vier Geräte erzeugen bei Mistral Medium 3.5 128B 3,04-mal so viele Token pro Sekunde wie eines. Wird das Modell dagegen nur schichtweise aufgeteilt (Pipeline), bleibt die Ausgabegeschwindigkeit gleich.
Apple Machine Learning Research, „Local and Distributed Large LLM Inference with MLX and RDMA on Mac Studio“, veröffentlicht am 15.10.2026: Mistral Medium 3.5 128B dense in FP8, Kontext 8.192 Token, eine Anfrage, 128 erzeugte Token, MLX mit Backend jaccl und der experimentellen Einstellung MLX_METAL_FAST_SYNCH=1, 2 Kabel je Verbindung. Weitere Werte derselben Messung: Qwen 3.8 27B 19,69 auf 50,89 Token/s (2,58×), Muse Spark Open 816B auf 4 Geräten 36,73 Token/s. Unabhängige Cluster-Tests mit M5 Ultra gab es bis 20.10.2026 nicht.
Welche Vorteile hat ein Mac Studio Cluster?
Der Cluster lohnt, wenn ein Modell für ein Gerät zu groß ist oder ein Gerät zu langsam antwortet. Die Daten bleiben dabei im eigenen Haus.
Vier Geräte mit 512 GB fassen Modelle wie Kimi K2.5 (658 GB) oder DeepSeek V4 Pro in 4 Bit (837 GB), die auf kein einzelnes Gerät passen.
Mit RDMA und Tensor-Parallelismus steigt die Ausgabe laut Apple mit 2 Geräten auf das 1,7- bis 1,8-Fache, mit 4 Geräten auf das 2,6- bis 3,0-Fache, gemessen bei 8.192 Token Kontext.
Bei 65.536 Token Kontext sank die Zeit bis zum ersten Token für Mistral Medium 3.5 von 273,0 s auf einem Gerät auf 80,0 s mit vier Geräten (Apple).
Apple hat bei der Inferenz rund 300 W Spitze je M5 Ultra gemessen, vier Geräte liegen nach unserer Hochrechnung bei rund 1.200 W. Die Geräte sind 9,5 cm hoch und laufen an normalen Steckdosen. Für den Schrank gibt es Rack-Halterungen für 2 Geräte auf 2,33 bis 3 HE.
Ein Cluster kann mit zwei Geräten starten und auf drei oder vier wachsen. Mit sechs Thunderbolt-5-Anschlüssen hat jedes M5 Ultra genug Ports für vier Geräte, auch mit zwei Kabeln je Verbindung.
MLX und das RDMA-Backend JACCL stammen von Apple und sind quelloffen. mlx_lm.server stellt das verteilte Modell als API im internen Netz bereit, exo bietet dasselbe mit Oberfläche und Ollama-kompatibler Schnittstelle.
Quellen: Apple Machine Learning Research (15.10.2026), Apple Technische Daten Mac Studio, MLX-Dokumentation, Hersteller-Seiten von Sonnet, myElectronics und Racknex (myElectronics führt seine 3-HE-Halterung im Shop für Mac Studio M5 Max und M5 Ultra; Sonnet und Racknex nennen M5 Ultra noch nicht, die Gehäusemaße sind gleich). Abgerufen am 20.10.2026.
Wie wird der Cluster eingerichtet?
Einen Schritt muss jemand an jedem Gerät selbst machen: RDMA lässt sich laut MLX-Dokumentation nicht aus der Ferne einschalten.
Alle Geräte brauchen mindestens macOS 26.2 und exakt dieselbe Version. exo verlangt das ausdrücklich, auch bei Beta-Builds.
Je Gerät in macOS Recovery das Terminal öffnen, rdma_ctl enable ausführen und neu starten. Prüfen mit ibv_devices.
Jedes Gerät mit jedem anderen verbinden. Die Anschlüsse werden erst aktiv, wenn alle verbundenen Geräte RDMA eingeschaltet haben.
Thunderbolt Bridge abschalten und je Kabel ein eigenes Teilnetz anlegen. mlx.distributed_config --auto-setup erledigt das mit sudo ohne Passwort und prüft dabei die Verkabelung.
Der Rechner, von dem aus gestartet wird, muss jedes Gerät ohne Passwort per SSH über Ethernet oder WLAN erreichen. Python und Skripte liegen auf allen Geräten unter demselben Pfad.
Beim verteilten Rechnen braucht jedes Gerät das komplette Modell auf der eigenen SSD und lädt davon seinen Anteil in den Arbeitsspeicher. mlx_lm.share kopiert es über die Thunderbolt-Verbindungen auf alle Knoten.
Ruhezustand aus, automatische Anmeldung an, Start nach Stromausfall an. Thunderbolt kennt kein Wake-on-LAN, ein schlafendes Gerät fällt aus dem Cluster.
mlx.launch mit Backend jaccl startet zum Beispiel mlx_lm.server auf allen Geräten. Mit --host steht das Modell danach als API im internen Netz bereit.
mlx_lm.server hat laut eigener Dokumentation nur einfache Sicherheitsprüfungen. Den Dienst deshalb nur im internen Netz anbieten, nicht im Internet.
Grundlage: Apple TN3205 (ergänzt am 13.04.2026), MLX-Dokumentation „Distributed Communication“ und „Launching Distributed Programs“ (MLX 0.32.4), exo-README. Apple zeigt in der WWDC26-Session 233 zusätzlich einen RDMA-Schalter in den Systemeinstellungen; ab welcher macOS-Version er kommt, nennt Apple nicht. Abgerufen am 20.10.2026.
Was spricht für den Cluster, was dagegen?
Dafür
- Modelle bis rund 1 TB Dateigröße laufen lokal, ohne Cloud und ohne Rechenzentrum.
- Messbar schneller: laut Apple 2,6- bis 3,0-fache Ausgabe mit vier Geräten.
- Ausbau in Schritten von zwei auf vier Geräte möglich.
- Werkzeuge von Apple (MLX, JACCL) quelloffen und aktiv gepflegt, MLX 0.32.4 vom Oktober 2026.
Dagegen
- Kein CUDA. Software, die NVIDIA voraussetzt, läuft nicht.
- Alle Messwerte gelten für eine Anfrage zur Zeit. Für den Betrieb mit vielen gleichzeitigen Nutzern gibt es keine veröffentlichten Zahlen.
- RDMA über Thunderbolt ist jung: In MLX sind Fehler offen, etwa bei einem abgezogenen Kabel im laufenden Betrieb.
- Die Server-Software ist jung: mlx_lm.server ist laut eigener Dokumentation wegen einfacher Sicherheitsprüfungen nicht für den Produktivbetrieb empfohlen, exo hat seit April 2026 kein neues Release.
Wann raten wir vom Cluster ab?
Ein Mac Studio mit 256 GB hat mehr Speicher als zwei mit 96 GB und kostet weniger. Erst wenn Tempo zählt, lohnt das zweite Gerät.
Einzelgerät konfigurierenFür eine Abteilung mit vielen parallelen Anfragen ist ein GPU-Server mit hoher Bandbreite und erprobten Inferenz-Servern die sichere Wahl.
Zum LLM-ServerWer auf NVIDIA-Software angewiesen ist, findet im DGX Spark 128 GB mit CUDA, im Server mehrere RTX PRO 6000 mit je 96 GB.
Zum DGX SparkHäufige Fragen zum Mac Studio Cluster
Was kostet ein Mac Studio Cluster?
Bei Nelpx kostet ein Cluster aus zwei Mac Studio M5 Ultra mit 30-Core CPU, 96 GB und 1 TB SSD 11.026,30 Euro netto. Vier Geräte mit 36-Core CPU, 256 GB und 1 TB kosten 41.541,24 Euro netto. Die Preise je Gerät stehen für 20 Kombinationen im Konfigurator (Stand 09.10.2026). Die 512-GB-Stufe ist bestellbar, ihren Preis nennt Nelpx im Angebot. Thunderbolt-5-Kabel kommen hinzu.
Brauche ich einen Thunderbolt-Switch für den Cluster?
Nein. RDMA über Thunderbolt verbindet laut Apple immer genau zwei Macs direkt und leitet keine Daten weiter. Jedes Gerät wird deshalb mit jedem anderen über ein eigenes Kabel verbunden: zwei Geräte brauchen 1 Kabel, drei Geräte 3, vier Geräte 6. Docks und Hubs dokumentiert Apple dafür nicht. Für SSH und Steuerung brauchen die Geräte zusätzlich ein normales Netzwerk über Ethernet oder WLAN.
Wie viele Mac Studio lassen sich zu einem Cluster verbinden?
Apple misst Cluster mit bis zu vier Mac Studio M5 Ultra, jedes Gerät mit den drei anderen verbunden; die Technote TN3205 zeigt zusätzlich einen Ring aus fünf Macs. Rechnerisch reichen die sechs Thunderbolt-5-Anschlüsse eines M5 Ultra für bis zu sieben Geräte in voller Vermaschung, veröffentlichte Messungen dazu gibt es aber nicht. Nelpx empfiehlt 2 oder 4 Geräte, weil sich die Matrixgrößen der meisten Modelle nicht durch 3 teilen lassen; mit 3 Geräten bleibt dann nur die schichtweise Verteilung ohne Tempogewinn. Für mehr Leistung ist ein GPU-Cluster die bessere Wahl.
Wird ein Modell auf vier Geräten viermal so schnell?
Nein, aber deutlich schneller. In Apples Messung vom 15.10.2026 erzeugten vier Mac Studio M5 Ultra bei Mistral Medium 3.5 128B 3,04-mal und bei Qwen 3.8 27B 2,58-mal so viele Token pro Sekunde wie ein Gerät. Voraussetzung ist Tensor-Parallelismus über RDMA. Wird das Modell nur schichtweise verteilt, bleibt die Ausgabe so schnell wie auf einem Gerät.
Funktioniert ein Mac-Cluster mit LM Studio oder Ollama?
Für ein Modell über mehrere Macs nicht direkt. LM Studio verbindet mit LM Link mehrere Geräte, nutzt jedes Modell aber auf einem einzelnen Gerät. Verteilt rechnen MLX mit mlx_lm.server und exo, beide auf Basis des Apple-Frameworks MLX. exo stellt eine Ollama-kompatible Schnittstelle bereit, sodass vorhandene Programme weiter funktionieren. llama.cpp kann seit August 2026 per RPC über RDMA verteilen, gilt laut eigener Dokumentation aber als Proof of Concept.
Cluster oder ein einzelner Mac Studio mit 512 GB?
Passt das Modell mit Reserve auf ein Gerät, ist ein einzelner Mac Studio einfacher: kein Kabel, keine Einrichtung, keine Abhängigkeit von RDMA. Ein Gerät mit 512 GB fasst Modelle bis rund 330 GB Dateigröße. Darüber oder wenn die Antworten schneller kommen sollen, lohnt der Cluster. Zwei Geräte mit 512 GB oder vier mit 256 GB fassen zum Beispiel Kimi K2.5 mit 658 GB.
Kann man auf einem Mac Studio Cluster Modelle trainieren?
Feintuning ja, wenn das Modell auf jedes einzelne Gerät passt. MLX verteilt dann die Trainingsdaten auf die Geräte und mittelt die Ergebnisse. Apple zeigte auf der WWDC26 mit vier Mac Studio M3 Ultra mehr als dreifaches Tempo beim Feintuning von Qwen 3.5 9B. Für das Training großer Modelle, die auf kein Gerät passen, gibt es in MLX LM keine fertige Funktion und keine veröffentlichten Messwerte. Dafür empfiehlt Nelpx GPU-Server.
Wie schnell ist ein Mac Studio Cluster mit großen Modellen?
Apple hat auf vier Mac Studio M5 Ultra das MoE-Modell Muse Spark Open mit 816 Milliarden Parametern gemessen: 36,73 Token pro Sekunde bei 8.192 Token Kontext und eine Anfrage zur Zeit. Mit dem Vorgänger M3 Ultra kam Jeff Geerling im Dezember 2025 mit Kimi K2 Thinking auf vier Geräten auf 28,3 Token pro Sekunde. Unabhängige Messungen mit M5-Ultra-Clustern gab es bis 20.10.2026 nicht.
Weitere Seiten
Mac Studio Cluster mit M5 Ultra: zwei bis vier Geräte für große Sprachmodelle
Mehrere Mac Studio mit M5 Ultra lassen sich direkt über Thunderbolt 5 mit RDMA verbinden. Das Modell wird auf die Geräte verteilt: Vier Geräte mit je 512 GB bringen 2 TB Arbeitsspeicher zusammen, und laut Apple-Messung erzeugen vier Geräte rund dreimal so viele Token pro Sekunde wie eines.
IT-Systemhaus für HPC & AI-Infrastruktur · Lieferung EU-weit · Konfiguration, Angebot und Lieferung aus einer Hand
Was ist ein Mac Studio Cluster?
Ein Mac Studio Cluster besteht aus zwei bis vier Mac Studio mit M5 Ultra, die direkt über Thunderbolt-5-Kabel verbunden sind. Seit macOS 26.2 tauschen die Geräte Daten per RDMA mit geringer Latenz aus. Software wie MLX oder exo verteilt ein Sprachmodell auf alle Geräte, sodass sich der Arbeitsspeicher addiert, mit vier Geräten zu je 512 GB auf 2 TB. Laut Apple erzeugen vier Geräte bei einem 128-Milliarden-Modell 3,04-mal so viele Token pro Sekunde wie eines. Nelpx liefert die Geräte EU-weit.
- Verbindung
- Thunderbolt 5 + RDMAdirekt, ohne Switch, ab macOS 26.2
- Speicher
- bis 2 TB4 × 512 GB, 1,2 TB/s je Gerät
- Tempo
- 2,6 bis 3,0×4 statt 1 Gerät bei 8.192 Token Kontext, Apple, veröffentlicht 15.10.2026
Quellen: Apple TN3205 „Low-latency communication with RDMA over Thunderbolt“, Apple Technische Daten Mac Studio (2026), Apple Machine Learning Research „Local and Distributed Large LLM Inference with MLX and RDMA on Mac Studio“ vom 15.10.2026. Abgerufen am 20.10.2026.
Wie werden die Mac Studio verkabelt?
Jedes Gerät wird mit jedem anderen direkt über ein Thunderbolt-5-Kabel verbunden. Dieser Aufbau heißt Full Mesh und ist der, den Apple misst. Switches für Thunderbolt 5 gibt es nach heutigem Stand nicht, und RDMA über Thunderbolt verbindet laut Apple immer nur zwei Macs direkt.
- 1 Thunderbolt-5-Kabel zwischen den beiden Geräten, je Gerät ist 1 Anschluss belegt.
- Mit 2 Kabeln verdoppelt sich die Bandbreite der Verbindung. MLX nutzt beide Kabel gleichzeitig.
- Speicher: 192, 512 oder 1.024 GB, je nach Ausbau mit 96, 256 oder 512 GB.
- Steuernetz: Beide Geräte brauchen zusätzlich eine Verbindung über Ethernet oder WLAN für SSH.
- 3 Thunderbolt-5-Kabel, jedes Gerät ist mit den beiden anderen verbunden, je Gerät sind 2 Anschlüsse belegt.
- Mit 2 Kabeln je Verbindung sind es 6 Kabel und 4 belegte Anschlüsse je Gerät.
- Speicher: 288, 768 oder 1.536 GB.
- Unsere Empfehlung: 2 oder 4 Geräte. Apple hat Messwerte nur für 2 und 4 Geräte veröffentlicht, und bei den meisten Modellen lassen sich die Matrixgrößen, etwa die Zwischendimension, nicht durch 3 teilen. Dann bieten exo und MLX für 3 Geräte nur die schichtweise Verteilung an, die nicht schneller ist.
- 6 Thunderbolt-5-Kabel, jedes Gerät ist mit den drei anderen verbunden, je Gerät sind 3 Anschlüsse belegt. So vermascht nennt Apple „bis zu 3× schneller“; die Messwerte vom Oktober 2026 entstanden mit 2 Kabeln je Verbindung.
- Mit 2 Kabeln je Verbindung sind es 12 Kabel, dann sind alle 6 Anschlüsse jedes Geräts belegt. In Apples Messung mit Muse Spark Open 816B sank die Wartezeit auf das erste Token bei einem 65.536-Token-Kontext dadurch von 50,5 auf 40,6 s.
- Speicher: 384, 1.024 oder 2.048 GB.
- Strom: Apple hat bei der Inferenz rund 300 W Spitze je M5 Ultra gemessen, für vier Geräte ergibt das nach unserer Hochrechnung rund 1.200 W. Ausgelegt ist jedes Gerät auf höchstens 480 W Dauerleistung.
Kabel: Apple nennt für RDMA keine Kabelempfehlung. Bewährt sind passive Thunderbolt-5-Kabel mit 1 m, zum Beispiel das Thunderbolt 5 (USB-C) Pro Kabel von Apple mit 80 Gbit/s in beide Richtungen und bis 120 Gbit/s in eine Richtung. Für längere Wege gibt es aktive Kabel. Grundlage: Apple TN3205, MLX-Dokumentation „Distributed Communication“, Apple Machine Learning Research (15.10.2026), Jeff Geerling (18.12.2025), Macworld (23.01.2026).
Mac Studio Cluster zusammenstellen und anfragen
Wählen Sie Anzahl und Ausstattung. Die Tempo-Angaben stammen aus Apples Messung mit 2 Kabeln je Verbindung. Rechts sehen Sie den Nettopreis je Gerät und für den Cluster, die Lieferzeit und welche Modelle hineinpassen. Alle Geräte eines Clusters sollten gleich ausgestattet sein.
Anzahl Mac Studio
Chip
Arbeitsspeicher je Gerät
SSD je Gerät
Beim verteilten Rechnen braucht jedes Gerät das komplette Modell auf der eigenen SSD und lädt davon seinen Anteil in den Arbeitsspeicher.
Thunderbolt-5-Kabel
Die Anzahl gilt für den ganzen Cluster: jedes Gerät mit jedem anderen direkt verbunden.
Angebot anfordern
Optional - die Angaben wandern in die E-Mail und ins PDF. Sie erhalten ein Angebot mit Nettopreis, Kabeln und Liefertermin.
Ihre Eingaben bleiben beim Ausfüllen vollständig in Ihrem Browser - übertragen wird erst beim aktiven Absenden der E-Mail. Datenschutzerklärung
Welches Modell braucht wie viele Mac Studio?
Die Tabelle rechnet mit der echten Dateigröße der MLX-Fassung auf Hugging Face plus 15 % Reserve für Kontext und Laufzeit. Als nutzbar rechnen wir mit rund drei Vierteln des Arbeitsspeichers, ein Erfahrungswert für das Standardlimit von macOS, das Apple nicht dokumentiert.
| Modell (MLX) | Dateigröße | 1 × 512 GB | 2 × 256 GB | 2 × 512 GB oder 4 × 256 GB | 4 × 512 GB |
|---|---|---|---|---|---|
| Qwen3.5 397B-A17B 4-Bit | 224 GB | passt | passt | passt | passt |
| MiniMax M3 4-Bit | 242 GB | passt | passt | passt | passt |
| DeepSeek V3.2 4-Bit | 378 GB | knapp* | knapp* | passt | passt |
| GLM-5.3 4-Bit | 418 GB | knapp* | knapp* | passt | passt |
| Qwen3.5 397B-A17B 8-Bit | 422 GB | knapp* | knapp* | passt | passt |
| Kimi K2.5 (INT4) | 658 GB | nein | nein | passt | passt |
| DeepSeek V3.2 8-Bit | 756 GB | nein | nein | knapp* | passt |
| DeepSeek V4 Pro 4-Bit | 837 GB | nein | nein | knapp* | passt |
* knapp = passt nur, wenn das GPU-Speicherlimit von macOS angehoben wird (Schlüssel iogpu.wired_limit_mb, von Apple nicht dokumentiert). Beim verteilten Rechnen (Tensor-Parallelismus) braucht jedes Gerät zusätzlich das ganze Modell auf der SSD, ab rund 600 GB empfehlen wir 2 TB. Dateigrößen: Summe der safetensors-Dateien der Repositories von mlx-community auf Hugging Face, GB = 10^9 Byte, abgerufen am 20.10.2026. Richtwert, kein Leistungsversprechen; sehr lange Kontexte brauchen mehr Reserve.
Wie viel schneller ist ein Cluster?
Bei verteiltem Rechnen (Tensor-Parallelismus) arbeiten alle Geräte gleichzeitig an jedem Token. Apple hat dazu am 15.10.2026 Messwerte mit M5 Ultra veröffentlicht: Vier Geräte erzeugen bei Mistral Medium 3.5 128B 3,04-mal so viele Token pro Sekunde wie eines. Wird das Modell dagegen nur schichtweise aufgeteilt (Pipeline), bleibt die Ausgabegeschwindigkeit gleich.
Apple Machine Learning Research, „Local and Distributed Large LLM Inference with MLX and RDMA on Mac Studio“, veröffentlicht am 15.10.2026: Mistral Medium 3.5 128B dense in FP8, Kontext 8.192 Token, eine Anfrage, 128 erzeugte Token, MLX mit Backend jaccl und der experimentellen Einstellung MLX_METAL_FAST_SYNCH=1, 2 Kabel je Verbindung. Weitere Werte derselben Messung: Qwen 3.8 27B 19,69 auf 50,89 Token/s (2,58×), Muse Spark Open 816B auf 4 Geräten 36,73 Token/s. Unabhängige Cluster-Tests mit M5 Ultra gab es bis 20.10.2026 nicht.
Welche Vorteile hat ein Mac Studio Cluster?
Der Cluster lohnt, wenn ein Modell für ein Gerät zu groß ist oder ein Gerät zu langsam antwortet. Die Daten bleiben dabei im eigenen Haus.
Vier Geräte mit 512 GB fassen Modelle wie Kimi K2.5 (658 GB) oder DeepSeek V4 Pro in 4 Bit (837 GB), die auf kein einzelnes Gerät passen.
Mit RDMA und Tensor-Parallelismus steigt die Ausgabe laut Apple mit 2 Geräten auf das 1,7- bis 1,8-Fache, mit 4 Geräten auf das 2,6- bis 3,0-Fache, gemessen bei 8.192 Token Kontext.
Bei 65.536 Token Kontext sank die Zeit bis zum ersten Token für Mistral Medium 3.5 von 273,0 s auf einem Gerät auf 80,0 s mit vier Geräten (Apple).
Apple hat bei der Inferenz rund 300 W Spitze je M5 Ultra gemessen, vier Geräte liegen nach unserer Hochrechnung bei rund 1.200 W. Die Geräte sind 9,5 cm hoch und laufen an normalen Steckdosen. Für den Schrank gibt es Rack-Halterungen für 2 Geräte auf 2,33 bis 3 HE.
Ein Cluster kann mit zwei Geräten starten und auf drei oder vier wachsen. Mit sechs Thunderbolt-5-Anschlüssen hat jedes M5 Ultra genug Ports für vier Geräte, auch mit zwei Kabeln je Verbindung.
MLX und das RDMA-Backend JACCL stammen von Apple und sind quelloffen. mlx_lm.server stellt das verteilte Modell als API im internen Netz bereit, exo bietet dasselbe mit Oberfläche und Ollama-kompatibler Schnittstelle.
Quellen: Apple Machine Learning Research (15.10.2026), Apple Technische Daten Mac Studio, MLX-Dokumentation, Hersteller-Seiten von Sonnet, myElectronics und Racknex (myElectronics führt seine 3-HE-Halterung im Shop für Mac Studio M5 Max und M5 Ultra; Sonnet und Racknex nennen M5 Ultra noch nicht, die Gehäusemaße sind gleich). Abgerufen am 20.10.2026.
Wie wird der Cluster eingerichtet?
Einen Schritt muss jemand an jedem Gerät selbst machen: RDMA lässt sich laut MLX-Dokumentation nicht aus der Ferne einschalten.
Alle Geräte brauchen mindestens macOS 26.2 und exakt dieselbe Version. exo verlangt das ausdrücklich, auch bei Beta-Builds.
Je Gerät in macOS Recovery das Terminal öffnen, rdma_ctl enable ausführen und neu starten. Prüfen mit ibv_devices.
Jedes Gerät mit jedem anderen verbinden. Die Anschlüsse werden erst aktiv, wenn alle verbundenen Geräte RDMA eingeschaltet haben.
Thunderbolt Bridge abschalten und je Kabel ein eigenes Teilnetz anlegen. mlx.distributed_config --auto-setup erledigt das mit sudo ohne Passwort und prüft dabei die Verkabelung.
Der Rechner, von dem aus gestartet wird, muss jedes Gerät ohne Passwort per SSH über Ethernet oder WLAN erreichen. Python und Skripte liegen auf allen Geräten unter demselben Pfad.
Beim verteilten Rechnen braucht jedes Gerät das komplette Modell auf der eigenen SSD und lädt davon seinen Anteil in den Arbeitsspeicher. mlx_lm.share kopiert es über die Thunderbolt-Verbindungen auf alle Knoten.
Ruhezustand aus, automatische Anmeldung an, Start nach Stromausfall an. Thunderbolt kennt kein Wake-on-LAN, ein schlafendes Gerät fällt aus dem Cluster.
mlx.launch mit Backend jaccl startet zum Beispiel mlx_lm.server auf allen Geräten. Mit --host steht das Modell danach als API im internen Netz bereit.
mlx_lm.server hat laut eigener Dokumentation nur einfache Sicherheitsprüfungen. Den Dienst deshalb nur im internen Netz anbieten, nicht im Internet.
Grundlage: Apple TN3205 (ergänzt am 13.04.2026), MLX-Dokumentation „Distributed Communication“ und „Launching Distributed Programs“ (MLX 0.32.4), exo-README. Apple zeigt in der WWDC26-Session 233 zusätzlich einen RDMA-Schalter in den Systemeinstellungen; ab welcher macOS-Version er kommt, nennt Apple nicht. Abgerufen am 20.10.2026.
Was spricht für den Cluster, was dagegen?
Dafür
- Modelle bis rund 1 TB Dateigröße laufen lokal, ohne Cloud und ohne Rechenzentrum.
- Messbar schneller: laut Apple 2,6- bis 3,0-fache Ausgabe mit vier Geräten.
- Ausbau in Schritten von zwei auf vier Geräte möglich.
- Werkzeuge von Apple (MLX, JACCL) quelloffen und aktiv gepflegt, MLX 0.32.4 vom Oktober 2026.
Dagegen
- Kein CUDA. Software, die NVIDIA voraussetzt, läuft nicht.
- Alle Messwerte gelten für eine Anfrage zur Zeit. Für den Betrieb mit vielen gleichzeitigen Nutzern gibt es keine veröffentlichten Zahlen.
- RDMA über Thunderbolt ist jung: In MLX sind Fehler offen, etwa bei einem abgezogenen Kabel im laufenden Betrieb.
- Die Server-Software ist jung: mlx_lm.server ist laut eigener Dokumentation wegen einfacher Sicherheitsprüfungen nicht für den Produktivbetrieb empfohlen, exo hat seit April 2026 kein neues Release.
Wann raten wir vom Cluster ab?
Ein Mac Studio mit 256 GB hat mehr Speicher als zwei mit 96 GB und kostet weniger. Erst wenn Tempo zählt, lohnt das zweite Gerät.
Einzelgerät konfigurierenFür eine Abteilung mit vielen parallelen Anfragen ist ein GPU-Server mit hoher Bandbreite und erprobten Inferenz-Servern die sichere Wahl.
Zum LLM-ServerWer auf NVIDIA-Software angewiesen ist, findet im DGX Spark 128 GB mit CUDA, im Server mehrere RTX PRO 6000 mit je 96 GB.
Zum DGX SparkHäufige Fragen zum Mac Studio Cluster
Was kostet ein Mac Studio Cluster?
Bei Nelpx kostet ein Cluster aus zwei Mac Studio M5 Ultra mit 30-Core CPU, 96 GB und 1 TB SSD 11.026,30 Euro netto. Vier Geräte mit 36-Core CPU, 256 GB und 1 TB kosten 41.541,24 Euro netto. Die Preise je Gerät stehen für 20 Kombinationen im Konfigurator (Stand 09.10.2026). Die 512-GB-Stufe ist bestellbar, ihren Preis nennt Nelpx im Angebot. Thunderbolt-5-Kabel kommen hinzu.
Brauche ich einen Thunderbolt-Switch für den Cluster?
Nein. RDMA über Thunderbolt verbindet laut Apple immer genau zwei Macs direkt und leitet keine Daten weiter. Jedes Gerät wird deshalb mit jedem anderen über ein eigenes Kabel verbunden: zwei Geräte brauchen 1 Kabel, drei Geräte 3, vier Geräte 6. Docks und Hubs dokumentiert Apple dafür nicht. Für SSH und Steuerung brauchen die Geräte zusätzlich ein normales Netzwerk über Ethernet oder WLAN.
Wie viele Mac Studio lassen sich zu einem Cluster verbinden?
Apple misst Cluster mit bis zu vier Mac Studio M5 Ultra, jedes Gerät mit den drei anderen verbunden; die Technote TN3205 zeigt zusätzlich einen Ring aus fünf Macs. Rechnerisch reichen die sechs Thunderbolt-5-Anschlüsse eines M5 Ultra für bis zu sieben Geräte in voller Vermaschung, veröffentlichte Messungen dazu gibt es aber nicht. Nelpx empfiehlt 2 oder 4 Geräte, weil sich die Matrixgrößen der meisten Modelle nicht durch 3 teilen lassen; mit 3 Geräten bleibt dann nur die schichtweise Verteilung ohne Tempogewinn. Für mehr Leistung ist ein GPU-Cluster die bessere Wahl.
Wird ein Modell auf vier Geräten viermal so schnell?
Nein, aber deutlich schneller. In Apples Messung vom 15.10.2026 erzeugten vier Mac Studio M5 Ultra bei Mistral Medium 3.5 128B 3,04-mal und bei Qwen 3.8 27B 2,58-mal so viele Token pro Sekunde wie ein Gerät. Voraussetzung ist Tensor-Parallelismus über RDMA. Wird das Modell nur schichtweise verteilt, bleibt die Ausgabe so schnell wie auf einem Gerät.
Funktioniert ein Mac-Cluster mit LM Studio oder Ollama?
Für ein Modell über mehrere Macs nicht direkt. LM Studio verbindet mit LM Link mehrere Geräte, nutzt jedes Modell aber auf einem einzelnen Gerät. Verteilt rechnen MLX mit mlx_lm.server und exo, beide auf Basis des Apple-Frameworks MLX. exo stellt eine Ollama-kompatible Schnittstelle bereit, sodass vorhandene Programme weiter funktionieren. llama.cpp kann seit August 2026 per RPC über RDMA verteilen, gilt laut eigener Dokumentation aber als Proof of Concept.
Cluster oder ein einzelner Mac Studio mit 512 GB?
Passt das Modell mit Reserve auf ein Gerät, ist ein einzelner Mac Studio einfacher: kein Kabel, keine Einrichtung, keine Abhängigkeit von RDMA. Ein Gerät mit 512 GB fasst Modelle bis rund 330 GB Dateigröße. Darüber oder wenn die Antworten schneller kommen sollen, lohnt der Cluster. Zwei Geräte mit 512 GB oder vier mit 256 GB fassen zum Beispiel Kimi K2.5 mit 658 GB.
Kann man auf einem Mac Studio Cluster Modelle trainieren?
Feintuning ja, wenn das Modell auf jedes einzelne Gerät passt. MLX verteilt dann die Trainingsdaten auf die Geräte und mittelt die Ergebnisse. Apple zeigte auf der WWDC26 mit vier Mac Studio M3 Ultra mehr als dreifaches Tempo beim Feintuning von Qwen 3.5 9B. Für das Training großer Modelle, die auf kein Gerät passen, gibt es in MLX LM keine fertige Funktion und keine veröffentlichten Messwerte. Dafür empfiehlt Nelpx GPU-Server.
Wie schnell ist ein Mac Studio Cluster mit großen Modellen?
Apple hat auf vier Mac Studio M5 Ultra das MoE-Modell Muse Spark Open mit 816 Milliarden Parametern gemessen: 36,73 Token pro Sekunde bei 8.192 Token Kontext und eine Anfrage zur Zeit. Mit dem Vorgänger M3 Ultra kam Jeff Geerling im Dezember 2025 mit Kimi K2 Thinking auf vier Geräten auf 28,3 Token pro Sekunde. Unabhängige Messungen mit M5-Ultra-Clustern gab es bis 20.10.2026 nicht.